同一次发布里的 Sol 和 Astra,在 FrontierCode 2.0 上只差 0.4 个百分点,单任务成本却是 1.29 美元对 5.97 美元。日常写代码该默认用哪个、什么时候强制切贵的那档,这篇给了一套路由策略。
OpenAI 同时发布 GPT-6.2 Sol 和 GPT-6.2 Astra 后,最值得关注的不是“哪个型号更强”,而是两者之间的价格和任务差距是否足以改变开发者的默认选择。
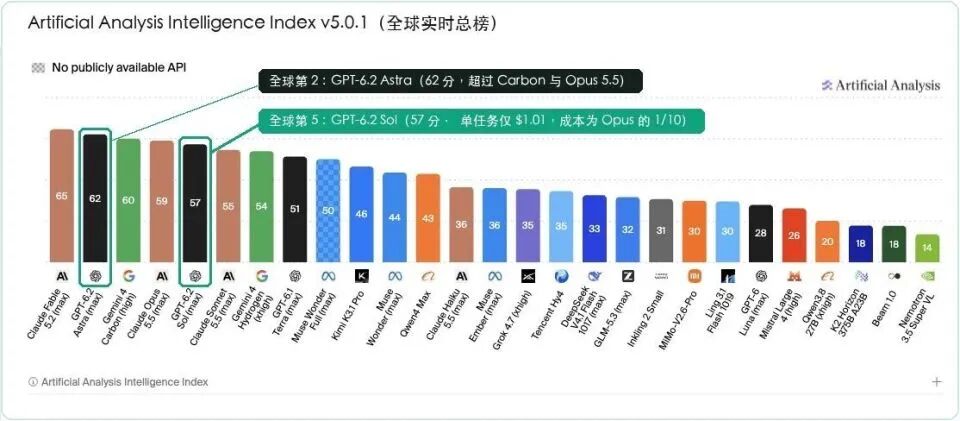
首发体验给出的结论很明确:日常写代码、办公和普通 Agent 任务可以优先使用 Sol;超长上下文、跨仓库大改、复杂财务建模和高难度版式还原,再切换到 Astra。两者不是简单的高低配,而是应该放进不同的路由层。
这对企业很重要。Agent 一次任务可能调用几十轮模型,模型选择如果只靠“默认最贵”,预算很快就会失控;如果所有任务都压到低价模型,复杂任务又会积累返工成本。
Sol 和 Astra 的差距,可能不值得日常多花钱
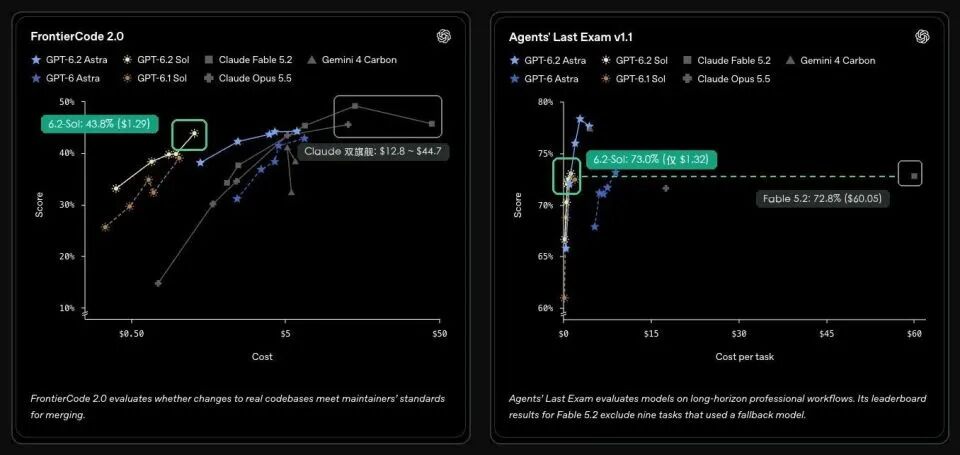
在 Cognition FrontierCode 2.0 真实开源仓库测试中,GPT-6.2 Astra 得分 44.2%,单任务成本约 5.97 美元;GPT-6.2 Sol 得分 43.8%,单任务成本约 1.29 美元。
两者只差 0.4 个百分点,Sol 的单任务成本却不到 Astra 的五分之一。Agents’ Last Exam v1.1 中,Sol 得分 73.0%,略高于 Claude Fable 5.2 的 72.8% 和 Claude Opus 5.5 的 71.6%,单题成本约 1.32 美元。
这些数字来自特定评测和配置,不能直接推导为所有代码库中的相同结果,但足以说明模型路由不能只按排行榜排序。企业更应该关注:
| 维度 | Sol 更适合 | Astra 更适合 |
|---|---|---|
| 任务长度 | 中短任务和常规迭代 | 长时间连续执行 |
| 代码范围 | 单服务、单仓库或局部修改 | 跨仓库、跨系统重构 |
| 成本敏感度 | 高频调用和批量任务 | 少量高价值任务 |
| 上下文复杂度 | 常规上下文 | 百万字资料、复杂表格和多源约束 |
| 交付方式 | 快速初稿与修复 | 深度规划、验证和最终审查 |
速度和 Token 效率,是 Agent 时代的核心指标
GPT-6.2 Sol 在复杂任务中表现出的另一个优势,是更少的输出 Token。原文引用 GDPval v2 数据:同样的设计、金融和代码任务,Claude Fable 5.2 平均输出 22.2 万 Token,Claude Opus 5.5 输出 19.1 万,GPT-6.2 Sol 只用了约 3.3 万 Token,Xhigh 档位约 1.88 万 Token,同时取得更高成绩。
如果这个结果能在企业真实任务中复现,模型节省的不只是 API 账单,还包括上下文传输、缓存占用、日志存储和下游解析成本。Agent 任务越长,冗余输出越容易被放大。
因此,模型评测应加入“单位有效产出”指标:
- 完成一次任务需要多少 Token;
- 输出中有多少是重复解释和无效过程;
- 失败重试前是否能准确定位问题;
- 最终代码、文档或报告是否需要人工大幅修改;
- 单任务从开始到交付的实际耗时。
只看上下文窗口和最高分,可能会把最贵、最慢的模型误选成默认模型。
前端审美回升,开发流程仍然要有验收
首发体验中,GPT-6.2 Sol 被认为明显改善了上一代模型的前端审美:页面排版、字体、间距、颜色和浏览器 3D 交互更自然;Artificial Analysis 的 AA-3D 双盲榜中,6.2-Sol 得分升到 1259,超过 Claude Opus 5.5 的 1202,6.2-Astra 则达到 1318。
开发者还展示了 3D 赛车网页、实时换色的电动露营车配置页和“鹈鹕骑自行车”SVG 测试。Higgsfield 的内部数据称,复杂 3D 场景一次通过率达到 73%。这些都说明模型更适合直接生成可运行的视觉原型。
但“看起来顺眼”不能代替前端验收。生产页面仍需要检查响应式布局、键盘和屏幕阅读器支持、资源加载、交互状态、移动端兼容和业务埋点。视觉模型负责快速给出高质量初稿,工程系统负责证明它能长期运行。
如何给 Sol 和 Astra 设计路由策略
不要把模型选择写死在业务代码里。可以把任务路由抽象成一组规则:
- 先按风险分级:代码生成、数据分析、外部发送、生产变更分别处理。
- 再按复杂度分级:上下文长度、预计工具调用数和任务时长进入路由条件。
- 默认用 Sol 生成计划、初稿和常规修复;当任务超过阈值时切 Astra。
- 让 Sol 负责大规模低风险任务,把 Astra 留给需要深度推理和最终验收的步骤。
- 记录每次路由的模型、成本、成功率和人工接管,定期调整阈值。
一个简单的策略示例:单仓库、少于 20 个文件、预计 10 分钟内完成的任务走 Sol;跨仓库重构、百万 Token 上下文、复杂财务表格和多轮失败恢复任务走 Astra;任何涉及生产发布和资金操作的任务都必须增加人工确认。
API 价格和订阅额度,不能只看宣传数字
原文给出的 API 价格是输入每百万 Token 2 美元、输出每百万 Token 10 美元,缓存命中为每百万 Token 0.10 美元。Pro 套餐的 Sol 支持 Ultrafast 模式,生成速度可达到标准模式的 4.5 倍,但会更快消耗周额度;Astra 适合更复杂的长任务,API 价格也已经调整。
企业需要把价格、速度和额度放进同一个预算模型。一个看似便宜的任务,如果开启极速模式、频繁重试并持续保留长上下文,最终仍可能超出预算。后台应该按任务记录 Token、工具、模型、重试和人工接管,而不是只看月度总账。
国内开发者如果希望通过 API 统一接入不同模型,可以了解 [Code80]https://code.ai80.vip/home 这类渠道;但模型路由、额度预算、密钥权限和任务验收仍需要自行维护。
常见问题
日常写代码应该选 Sol 还是 Astra?
优先从 Sol 开始。单仓库、局部修改、普通测试和日常办公任务通常不需要最贵模型;跨仓库重构、长上下文和复杂验证再切 Astra。
Sol 和 Astra 的编程能力差距大吗?
在原文引用的 FrontierCode 2.0 测试中,两者只差 0.4 个百分点,但测试分布和真实代码库不同,不能据此保证所有项目都相同。
为什么少输出 Token 也能提升效果?
有效规划和工具调用更紧凑,减少重复解释和无效过程,可能同时降低成本、延迟和上下文污染。但仍要用真实任务验证,而不是只看单次样例。
前端生成效果变好后,还需要人工验收吗?
需要。视觉效果之外,还要检查可访问性、响应式、性能、业务交互、埋点和安全。模型适合生成初稿和迭代,不能替代完整验收。
什么时候应该强制切换 Astra?
当任务涉及百万级上下文、跨仓库修改、复杂数据建模、长时间多工具执行或多次失败恢复时,可以切换 Astra,并保留人工确认和预算上限。
国内团队如何接入 GPT-6.2 Sol/Astra?
可以通过 Code80 等 API 渠道降低接入摩擦,但仍需自行管理模型路由、密钥、额度、日志审计和生产权限。
本文由人人都是产品经理作者【易安说AI】,微信公众号:【易安说AI】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载。
题图来自作者提供