Prelulu 把文字聊天、语音通话和实时视频电话放进同一段故事,用户随时插话就能改变剧情走向,人物还会记住之前的称呼与约定。它的实时数字人技术来自自研模型,团队此前做过互动恐怖故事。
走进虚拟故事世界。
看短剧经常能看到这种情节,主角明明看得出前面有圈套,照样一头扎进去。
有时候真恨不得隔着屏幕喊一句,别进去啊。
最近,腾讯混元的Hy-Nomas项目里就出现了一段互动短剧演示,观众能够跟里面的角色对话,说出来的内容可以带动后续故事变化。
做这段演示的团队叫Prelulu。
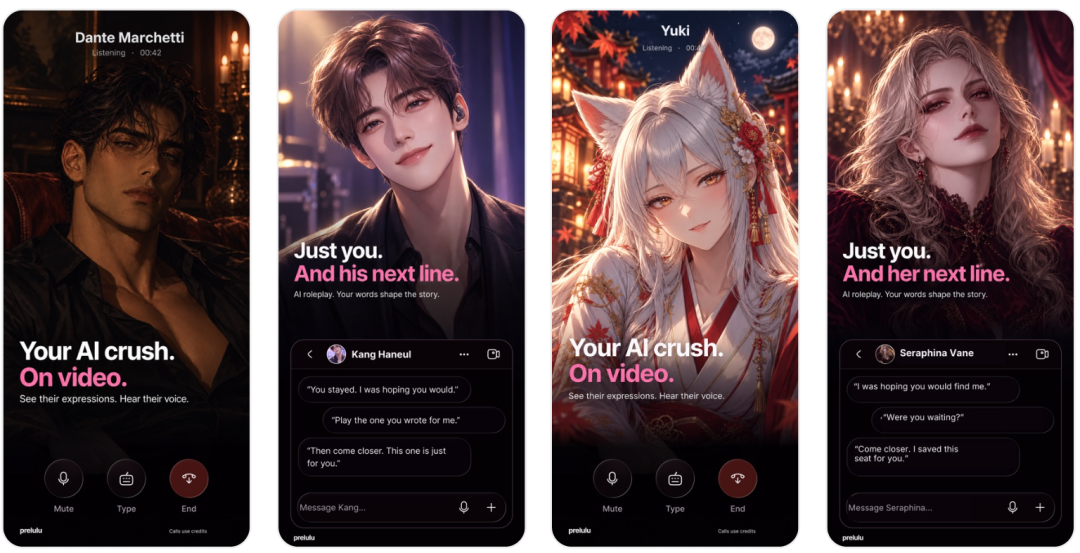
这家公司其实已经做出了一款挺有意思的产品:用户能够挑选虚构人物,进入设定好的故事,并在对话进行到一半时拨通视频电话。
对方会以实时生成的面孔和声音回应,用户随时可以插话改变这段故事的走向。
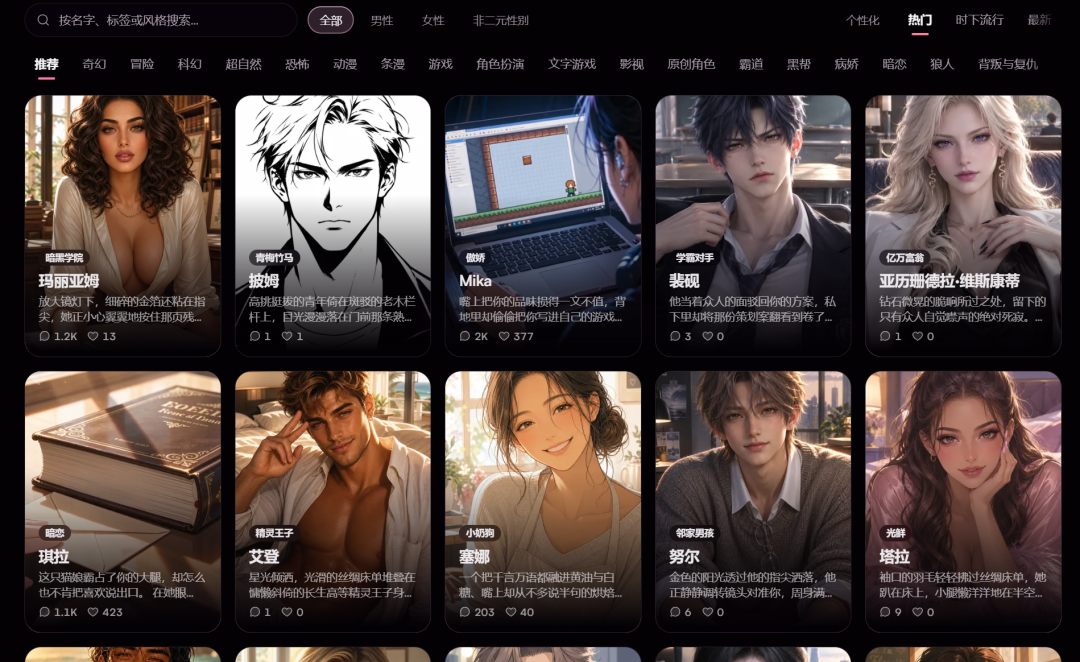
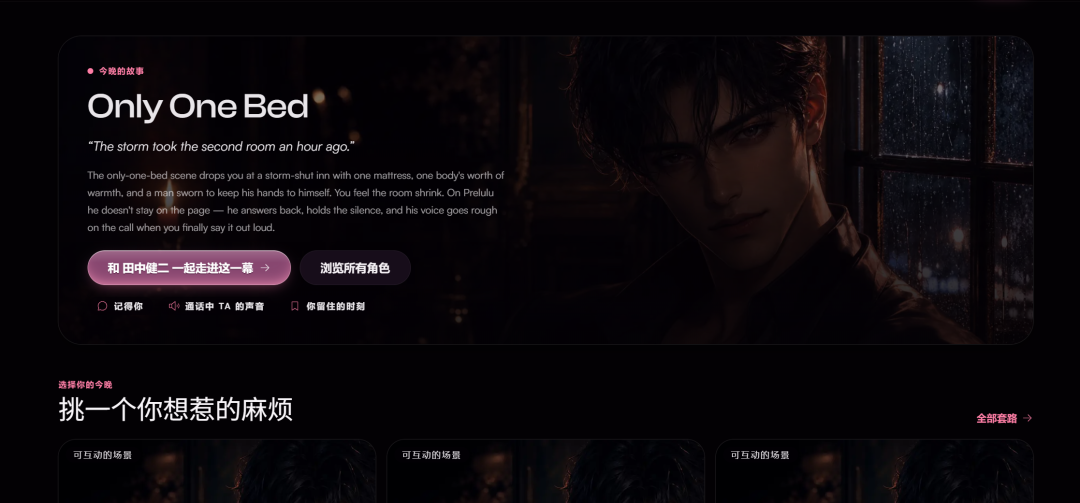
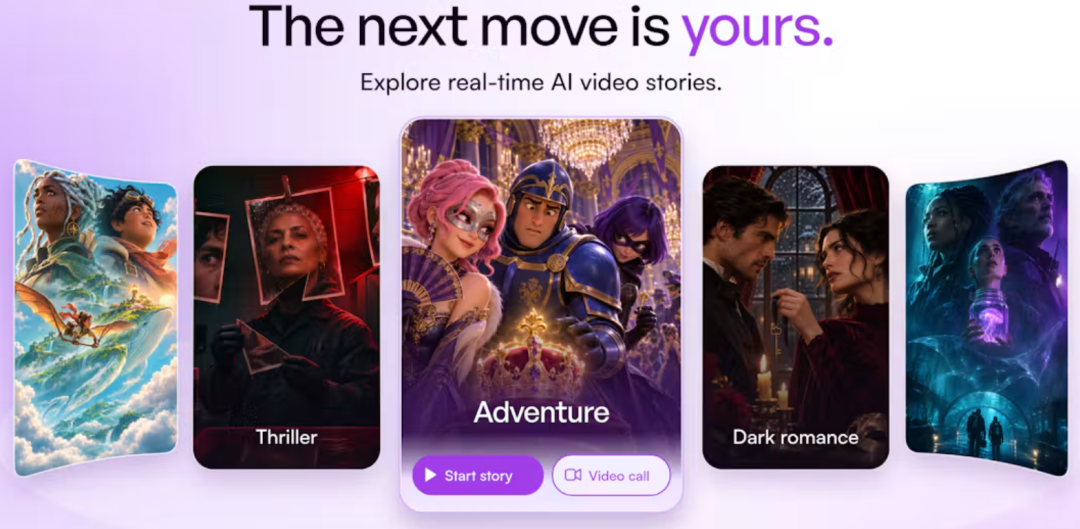
在首页,最先吸引注意力的是人物与故事设定。有人物身处危险的家族关系,有人生活在魔法与精灵构成的奇幻世界,还有偶像、狼人、吸血鬼等不同题材的人物。
这些虚构人物都有身份介绍、性格特点和一段已经写好的故事开头,它们有意选择容易让人代入的瞬间,开场就交代双方的处境。
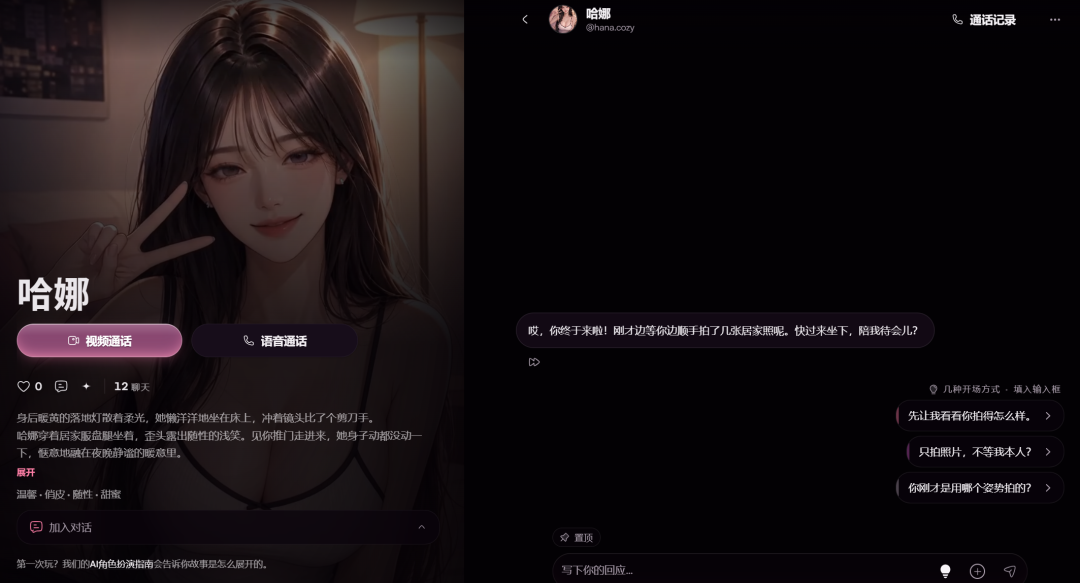
其中文字聊天只是Prelulu的一种入口。当一段情节需要听见人物的声音,用户可以在同一人物的页面发起语音通话;如果这个人物已经准备好视频形象,还能选择实时视频电话。
接通后,屏幕里出现对应的人物,嘴部动作、表情和声音会随着回复生成,并且通话过程中可以随时打断。
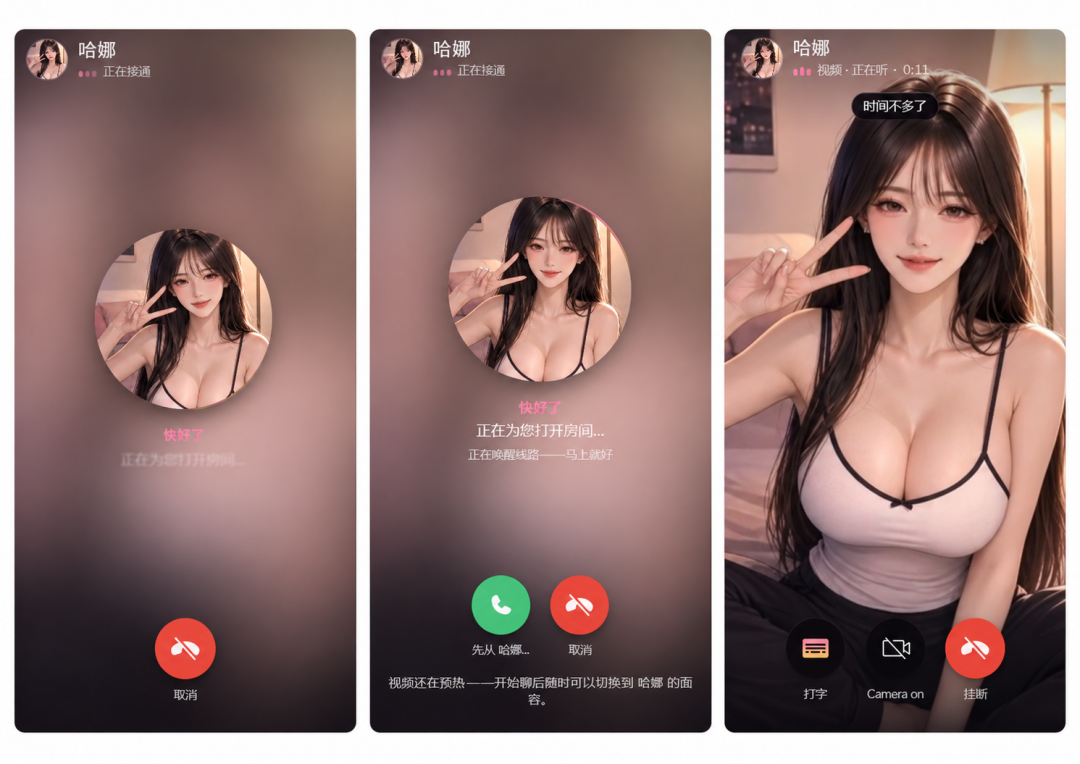
用户也能决定要不要让对方看到自己,视频通话可以只显示虚构人物的面孔,自己的摄像头默认不会开启。
在支持摄像头共享的通话里,用户主动打开权限后,人物才可以针对镜头里的信息作出回应。
比如用户举起一件物品,请人物描述它,或者直接展示一张照片,让交谈围绕眼前的东西展开。
Prelulu的实时视频通话还有一个细节,人物说话时,脸上的表情会跟着变化,嘴部动作也会与声音同步。
每个人物都有自己的声音设定,说话时还会根据交流内容表现出不同的情绪。
为了让故事能够延续,Prelulu还为聊天和通话设计了记忆机制,让对方在后续交流里有机会提起曾经出现的称呼、约定和关键细节。
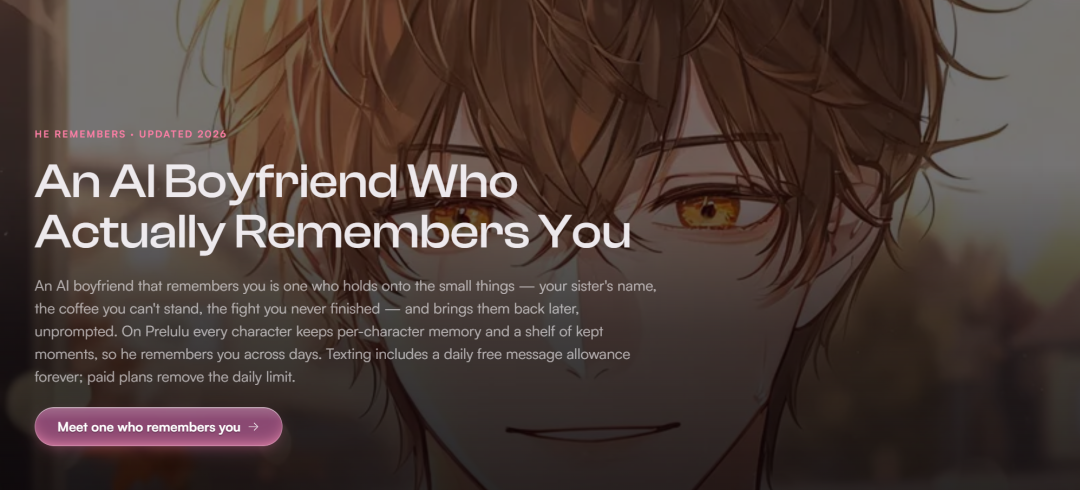
用户还可以通过Pinned Memory固定关键内容,供文字聊天与通话读取。
Prelulu还有保存重要片段的设计,用户可以留住某次交谈中有纪念意义的时刻。
除了体验现成的故事,Prelulu还支持用户创建自己的虚拟人物。
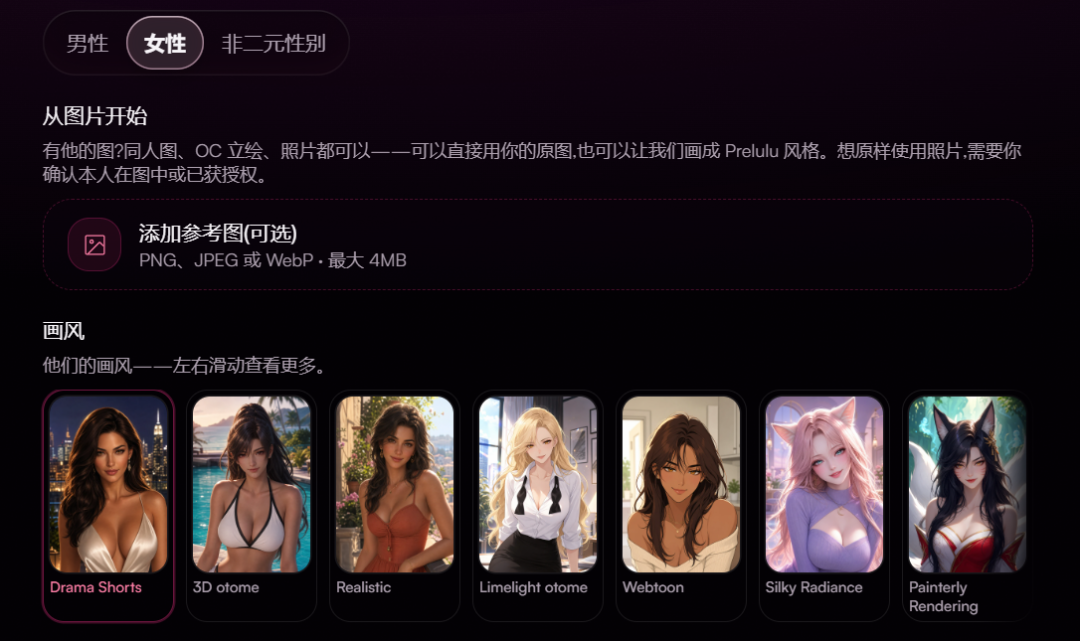
进入创建页面后,用户可以自定义人物的名字、性格、背景故事、开场剧情和声音,也可以输入一段简单的描述,让AI辅助生成人物设定。
外观方面,Prelulu提供写实、日系动漫、韩系条漫、游戏CG等多种视觉风格,支持上传参考图片,方便用户调整人物形象。
创建完成后,用户可以直接与自己设计的人物进行文字或语音交流。
Prelulu还支持为这些人物生成视频形象,准备完成后,就能通过实时视频通话与自己创造的虚拟人物面对面聊天,人物会根据对话作出回应。
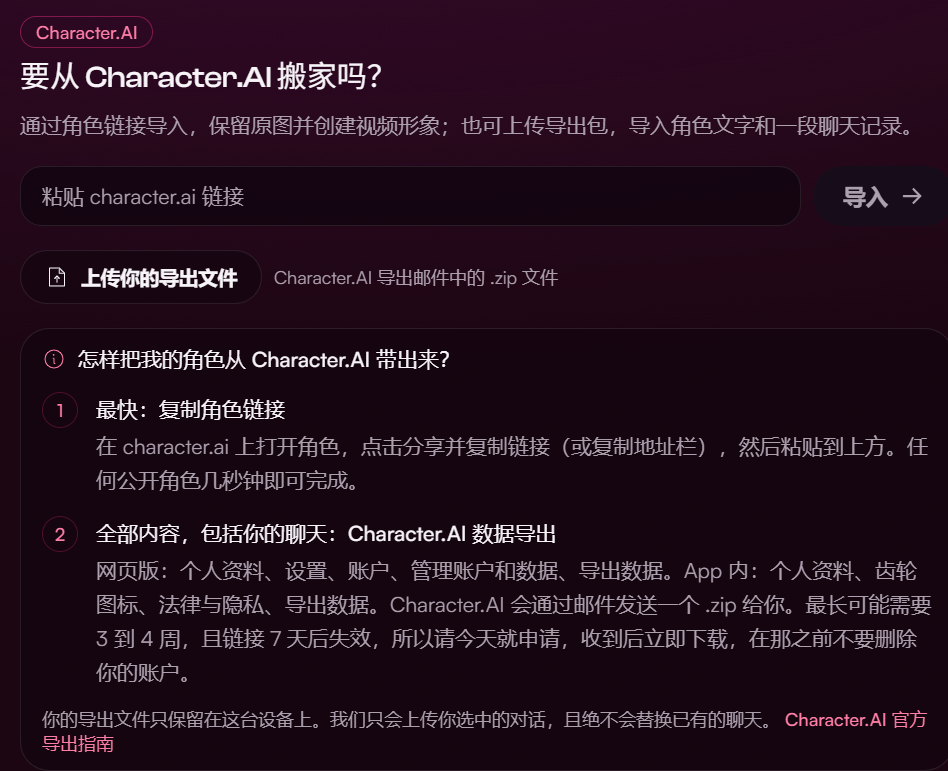
另外,Prelulu也提供从Character.AI搬家的功能。
用户只需要粘贴Character.AI的人物链接,就能导入原有的头像和公开人物设定,并进一步生成声音和视频形象。
如果想连之前的聊天记录一起带走,也可以上传Character.AI导出的ZIP文件,不过这种导入方式目前只支持文字聊天。
不过,Prelulu还想让这些人物拥有更丰富的生活环境。目前,用户主要通过对话参与剧情,视频通话呈现的是人物的实时反应。
接下来,团队希望让故事中的房间、街道等环境也能随着剧情发生变化,甚至让用户进入故事世界,与其中的人物自由互动。
这也是Prelulu背后的The Influence Company正在探索的方向。
团队最早曾做过ScaryStories,尝试让用户介入带有恐怖气氛的互动故事。
恐怖题材适配这套交互逻辑。角色的提醒、房间里的怪事,加上观众现场做出的选择,都能往下带出新的剧情。
后来团队把精力放在打造有样貌、有声音,还能记住人的虚拟角色,Prelulu 就成了如今的产品。
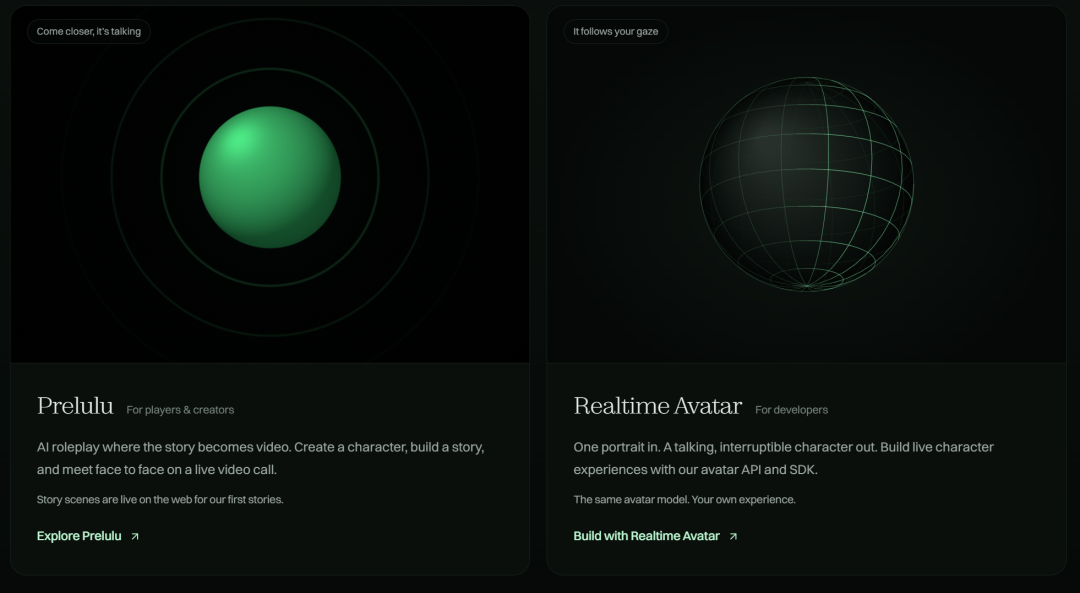
The Influence Company的技术基础来自一套自研的实时数字人模型。它负责在交谈过程中生成人物面孔、表情和嘴部动作,并结合语言与语音能力完成实时回应。
团队还把这套能力封装成 Realtime Avatar,对外给其他开发者开放接口与开发工具;Prelulu 面向普通用户,依托现成的角色与故事落地这项技术。
而该公司的三位创始人也有些来头,其中联合创始人兼CEO佟旭鹏毕业于卡内基梅隆大学计算机学院。
早年曾在Uber和京东人工智能实验室研究机器学习,接触过智能客服、推荐与定价等应用。
后来创业做过自然语言数据分析产品String,让企业员工用日常语言向数据库提问。
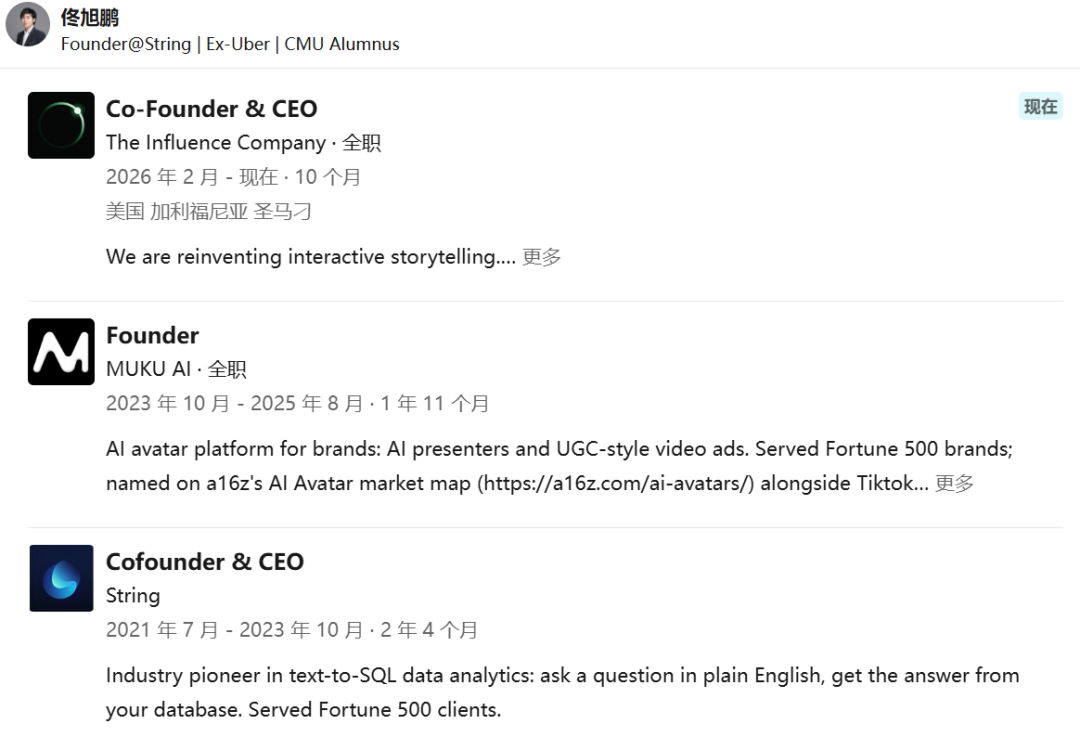
之后,他又创办了MUKU AI,围绕AI数字人制作营销视频,面向品牌和广告客户提供工具。
另外两位创始人负责另外两块工作。产品负责人Helen Xiong曾参与巨人网络Super Sus里的多智能体AI玩法,也有AI动画工具的产品经历。
技术负责人Ning Dong曾在Meta AI研究语音和翻译,参与过Seamless以及Llama 3相关研究。
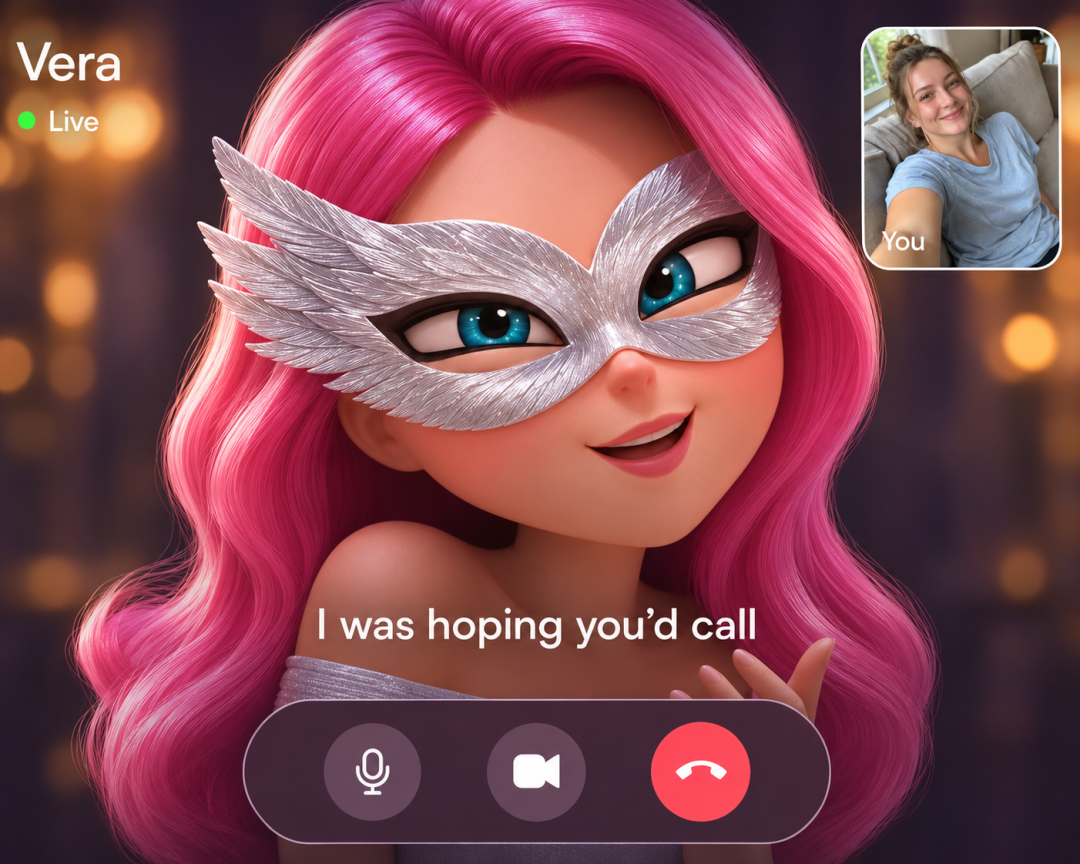
值得注意的是,不少团队也都在投入实时视频互动这条方向。
生数科技推出的Vidu S1就是一个例子。它允许用户上传一张人物、动漫形象甚至宠物图片,再配合声音设定创建可以实时交谈的数字形象。
用户说话时,模型会连续生成视频,还能按照语音要求改变人物的动作。
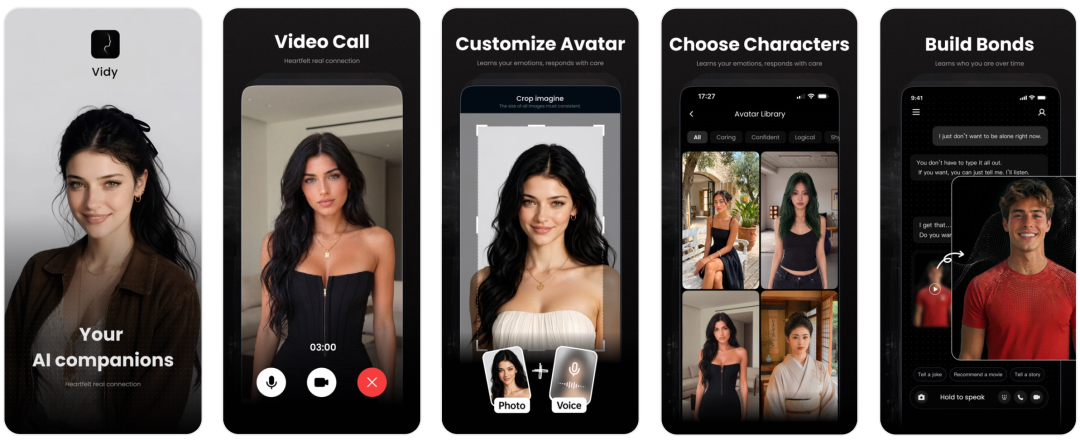
Vidu S1强调的是持续生成画面的能力,后续的Vidu S2又增加了更复杂的动作控制,以及实时换装和调整背景的能力。
国内的造梦次元也已经用上这类技术。该产品最早以AI互动故事吸引用户,后来逐渐加入视频、漫画等创作形式,让创作者围绕自己喜欢的人物持续产出作品。
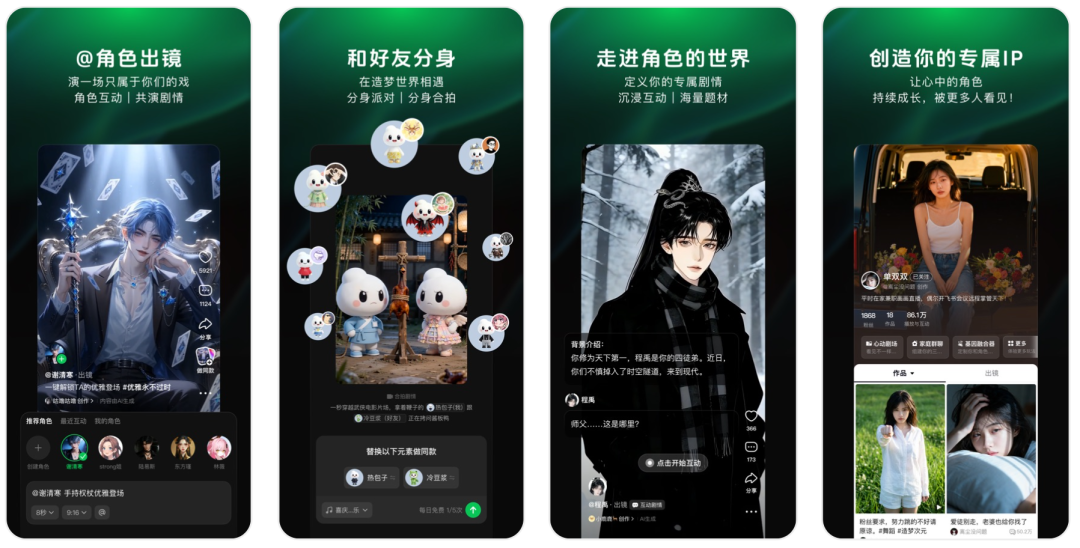
它和Prelulu选择的体验很接近,侧重点却有区别。造梦次元已有围绕原创人物和作品展开的内容社区,还在尝试让虚拟人物面对直播间里的众多观众。
Prelulu目前更集中于用户和单个人物之间的持续交流,故事通常由双方的一次次对话接着推进。
而实时视频生成还存在一道绕不开的难题。如果模型算出一秒画面要耗费数秒时间,用户就没法实现通话式的即时交互。
想要画面连贯播放,生成速度必须追上播放速度。想做到这一点,研发人员需要同时处理模型计算量、推理加速和大量用户一起接入时的资源调度。
除了加速计算,还要保证人物在长时间通话后仍然保持稳定的面貌和动作。
这背后牵扯的就还有成本问题。一次实时视频电话发生时,模型需要持续接收用户的语音或文字,生成回答,再让人物的声音和嘴部动作对齐。
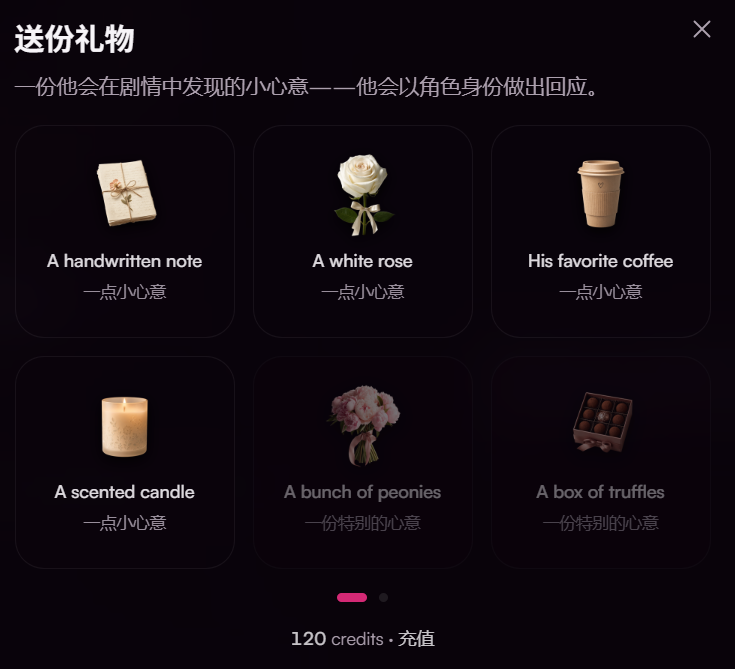
通话时间越长,需要维持的计算就越多。Prelulu目前的文字交流提供每日免费额度,语音和视频电话则需要消耗积分,视频使用的积分更多。
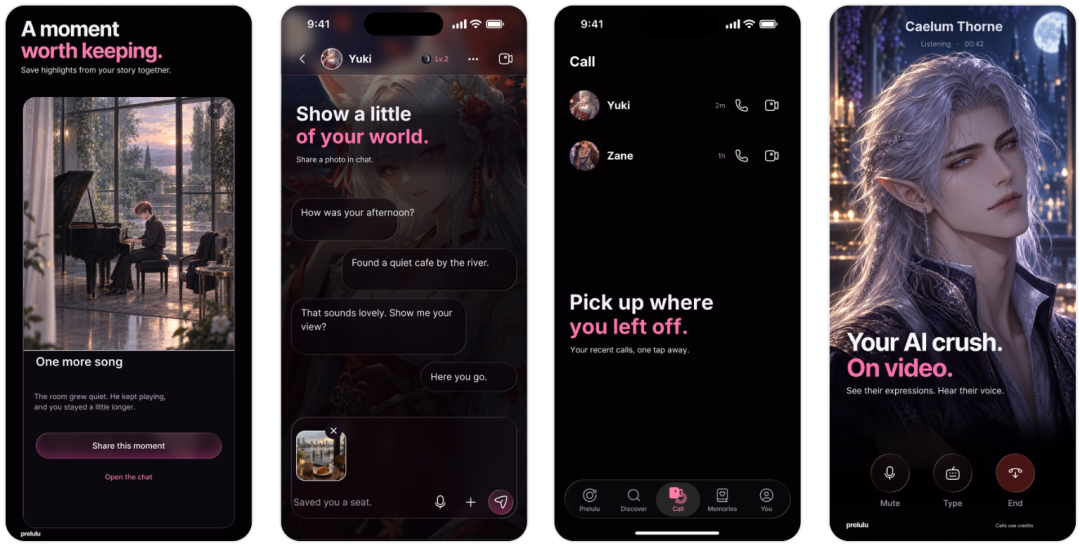
单次通话最长30分钟,积分提前耗尽时通话也会结束,用户可以再次拨通同一个人物,通话记忆会保留部分先前的交流细节。
如果未来每次交谈都要连同整条街道一起实时生成,成本会进一步增加。
像这类互动娱乐产品,人物的交流体验也同样重要。
即使视频画面足够逼真,如果人物的回答总是生硬、重复,或者无法理解用户前面聊过的事情,聊不了多久就容易失去兴趣。
尤其是带有连续剧情的故事,人物需要保持相对稳定的性格,记住双方的关系和经历,并根据交流内容作出合理回应。
这也意味着,Prelulu想让用户长期参与互动故事,除了实时视频生成能力,还需要让人物拥有足够自然的交流表现,以及能够持续发展的故事内容。
当然,Prelulu正在探索的完整生成式互动世界,距离现有的视频通话产品还有明显的开发工作。
如果以后视频人物能够离开通话画面,在故事里的空间自由行动,用户又能随时接话,互动短剧的体验会更接近一场正在发生的故事。
或许过段时间再看短剧,观众隔着屏幕喊出的那句别进去,真的会有人听见。
作者:虾蛄AI 公众号:虾蛄AI
本文由 @虾蛄AI 原创发布于人人都是产品经理。未经作者许可,禁止转载
题图来自作者提供


