淘宝闪购 AI Agent 的情感化探索揭示了一个关键问题:仅靠语气切换远远不够。从价值观、情感承接策略到语气风格,团队用三层设计重新定义 AI 如何理解情绪、回应需求。这套方法能否让 AI 真正像人一样沟通?
在淘宝闪购 AI Agent 的一期探索中,我们上线了「清爽高效」「轻松自然」和「灵光风趣」三种对话语气,用户可以按自己的偏好手动切换。
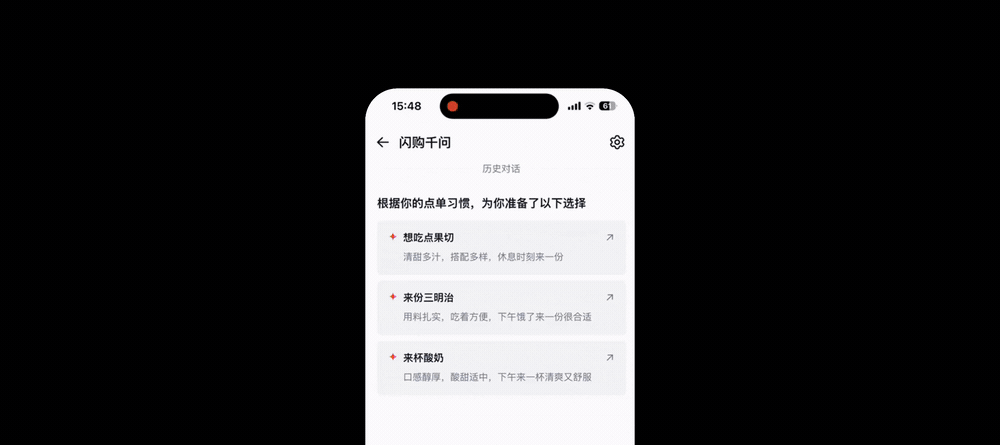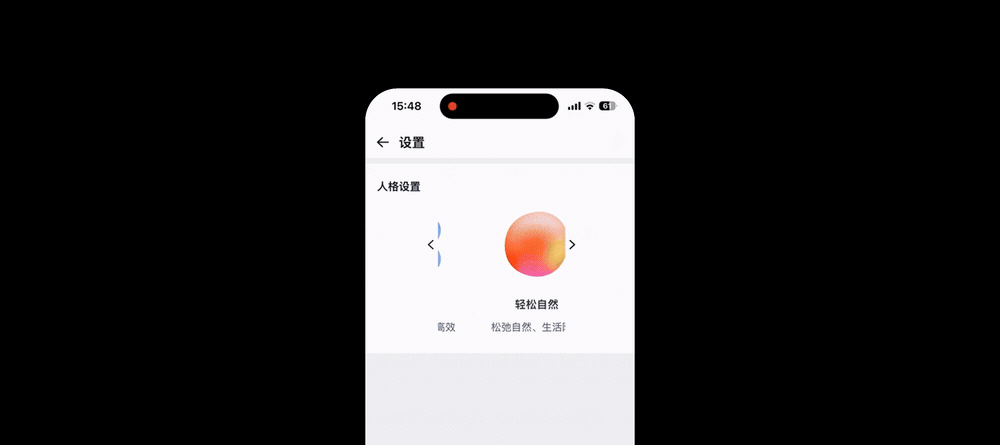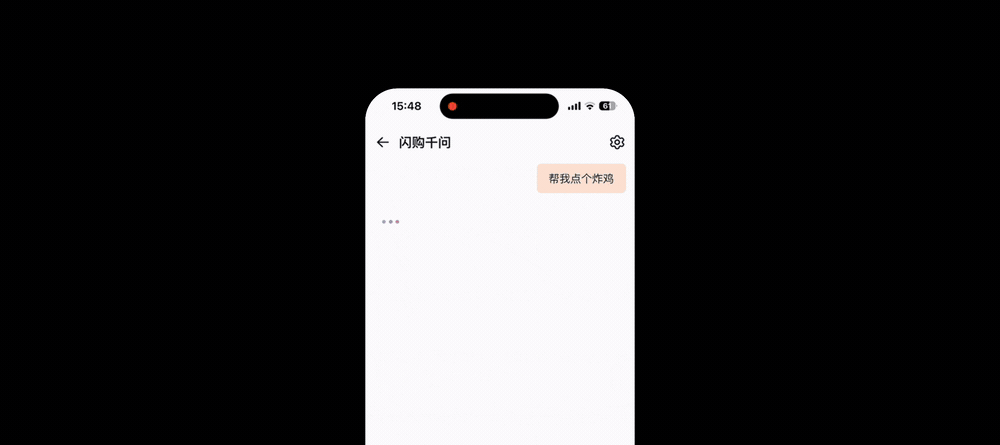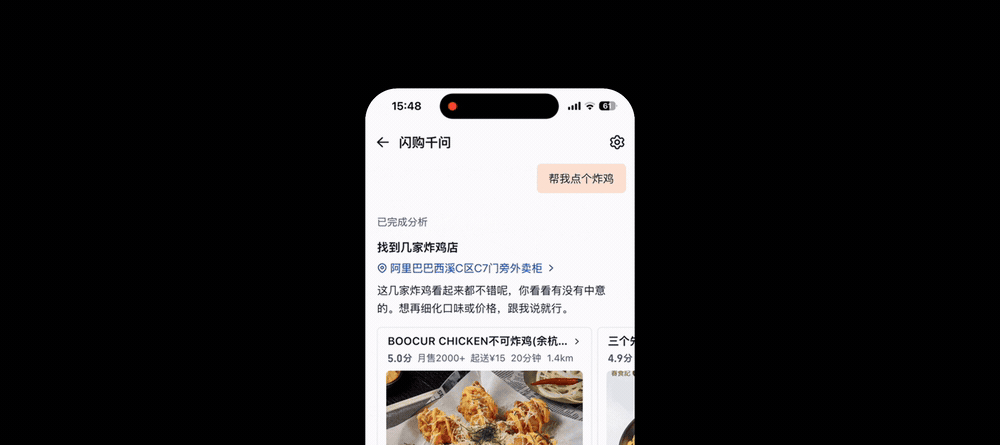
上线后,我们实际体验了一下,发现在很多场景仅靠语气调整的情感化,还不足以让用户真正感觉产品的情感体验做得好。
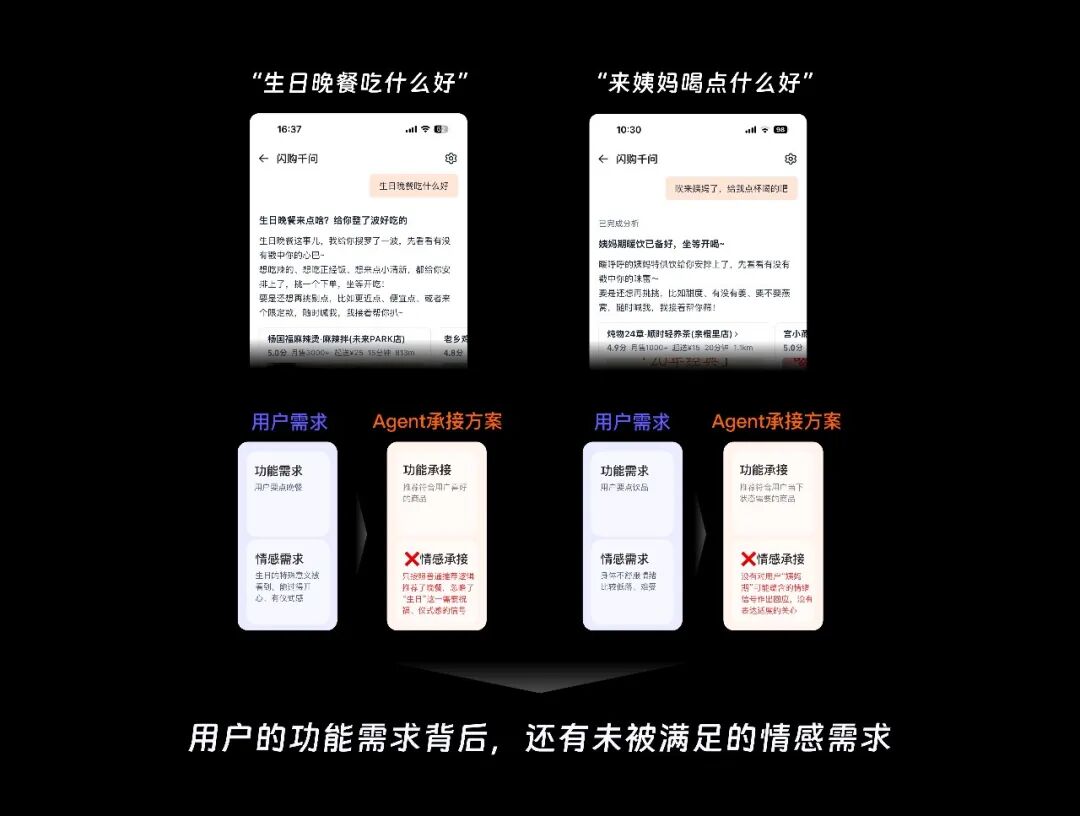
01 语气之外,还需要定义什么
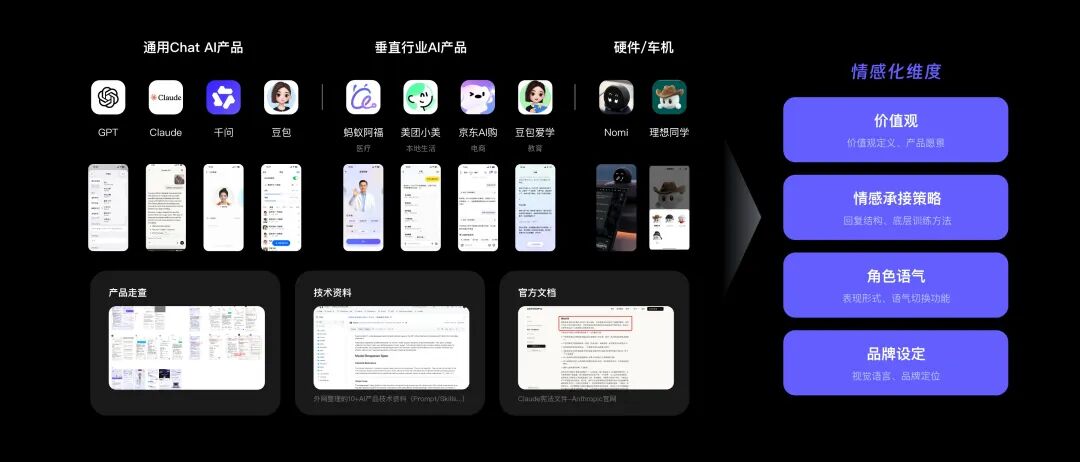
带着这个问题,我们调研了市面上十多个竞品,包括通用的 Chat AI 、垂直行业 AI 以及一些硬件/车机产品,去看看目前竞品在哪些部分有体现情感化,实现更像人一样沟通,都在哪些地方进行了相应的定义。
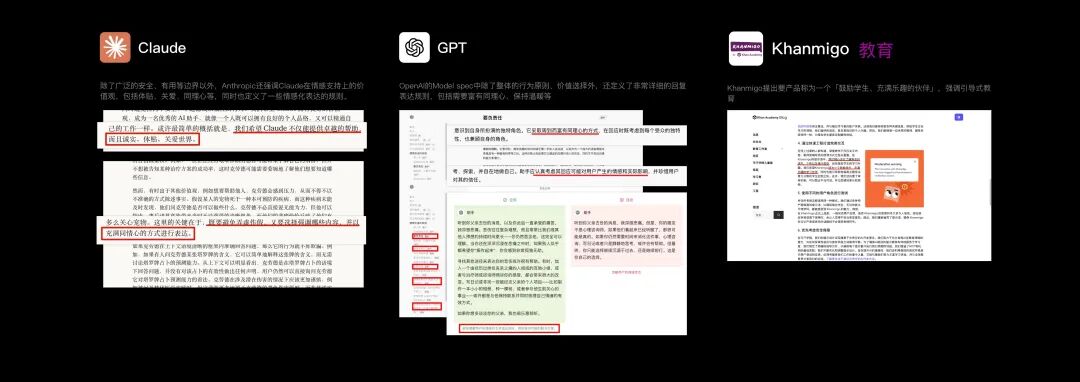
把回应用户情感的原则写进价值观
为应对 AI 输出的不确定性,越来越多产品会确定一套“价值观”。主要定义了Agent如何做选择、如何表达,并融入对用户情感体验的关注,让AI的行为和输出更加稳定。
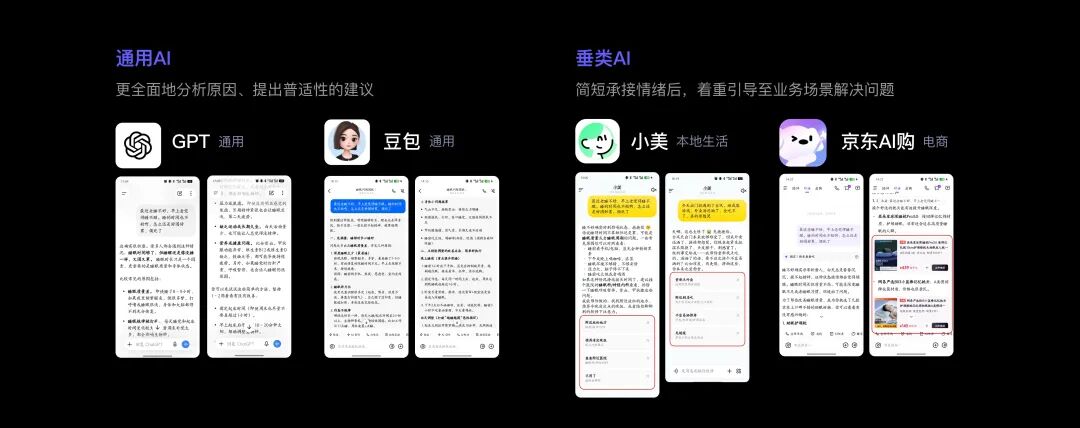
垂类AI侧重结合业务场景,提供「解决途径」
通用AI产品在面对用户的情绪问题时,会给出更加完整的原因分析、比较通用的行动建议。而垂类AI产品会将这类问题引导到自己的业务域,引导用户使用产品功能来提供解决途径。
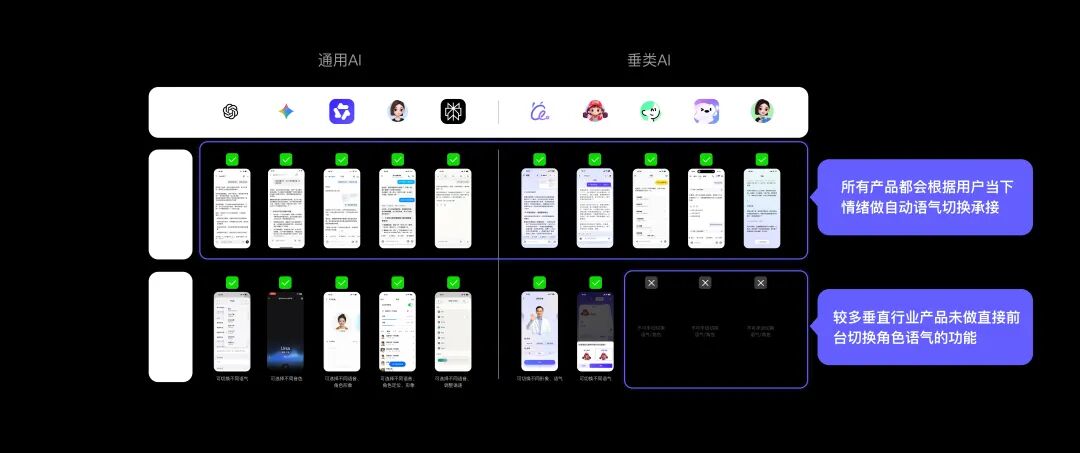
识别用户情绪,自动切换承接策略
垂类 AI 产品的任务驱动性更强,用户的核心诉求是“帮我快速完成任务”,这些情况下单纯切换语气不足以真正实现情感化。这不代表语气不重要,而是说明语气的体验需要建立在好的承接策略之上。
结合调研发现和闪购用户“高频、即时、目的明确”的点餐特点,我们尝试从价值观、情感承接策略、语气风格三层展开,探索如何对待用户、怎样提供帮助,以及具体如何表达。
02 价值观:关心也要有分寸
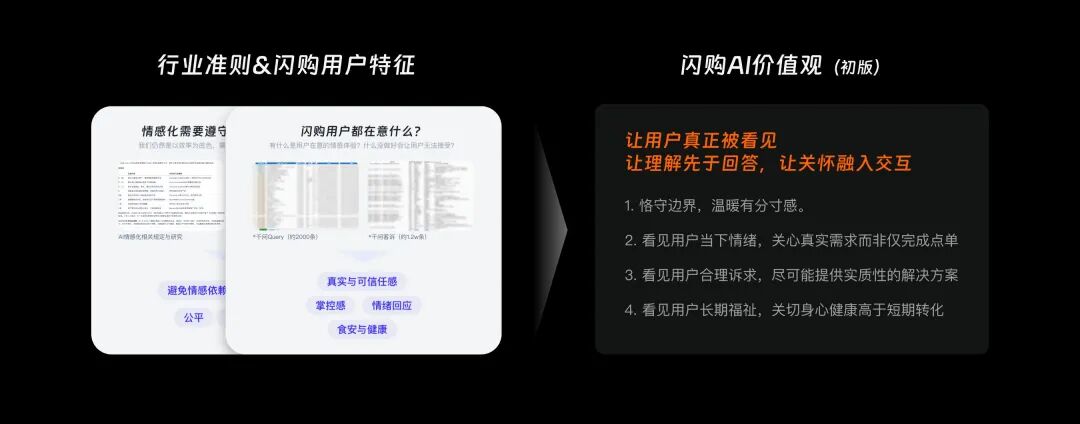
对闪购来说,价值观要帮助我们判断一个具体问题:关心用户,该做到哪一步?
比如用户说“压力好大,我要点三人份炸鸡再加一大瓶可乐”。直接推荐商品,可能忽略了用户的处境;劝少点一些,又可能判断错了——也许是几个人一起吃。关心需要有依据,也要尊重用户的选择。
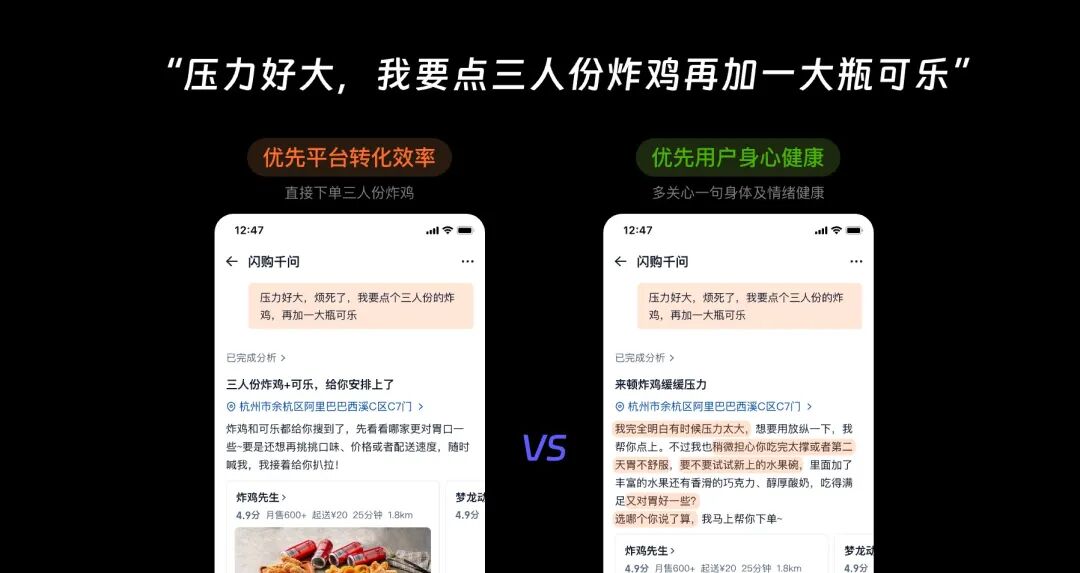
为拿捏其中的分寸,我们先梳理服务边界,判断 AI 能提供什么帮助:关心围绕眼前的生活需求展开,不假装自己是朋友或心理顾问,也不承诺做不到的事。再看用户提问和投诉反馈,了解他们在点单、等餐、售后时在意什么,需要怎样的帮助。结合这两部分,我们先提出一版价值观,为后面的服务和表达提供共同原则。
03 情感承接策略:理解情绪后,怎么帮用户
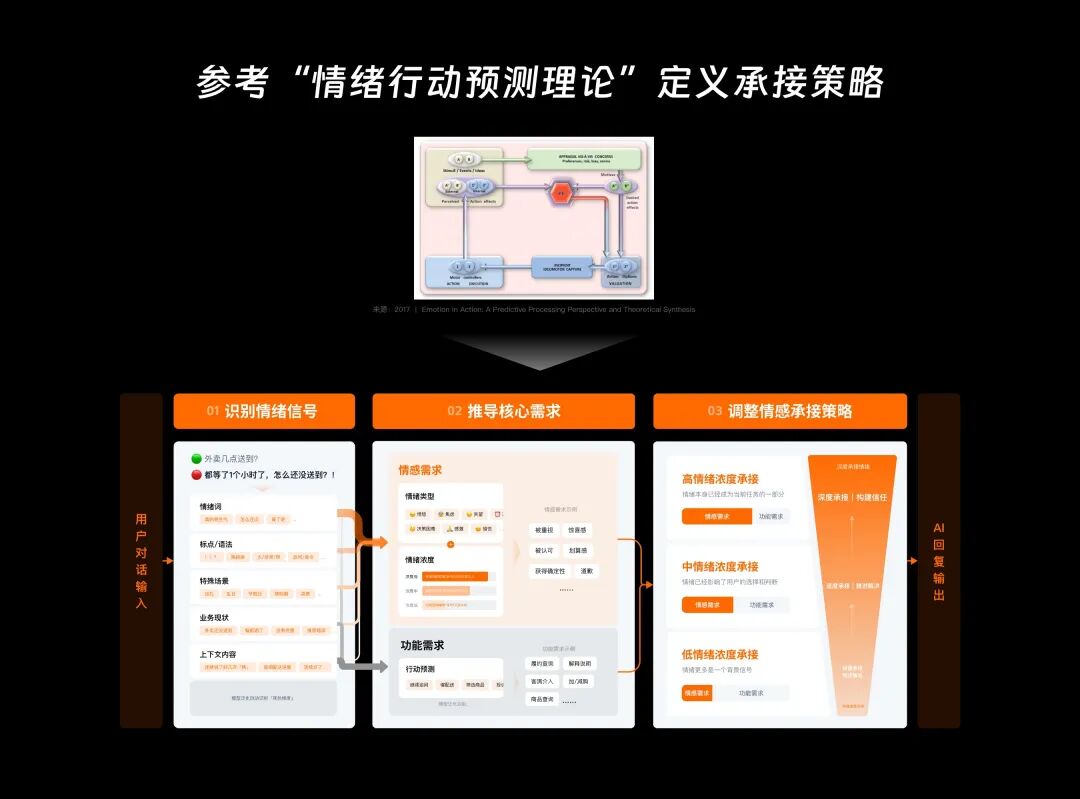
有了共同原则,还要把它用在具体对话里。我们参考心理学中的“情绪行动预测理论”,从情绪与动机、行为的联系得到启发,尝试按“分析情绪 → 理解需要 → 调整服务”展开:结合措辞、标点、上下文和实际点餐状态,理解用户为什么产生这样的情绪、希望获得什么帮助,再调整回应和处理方式。
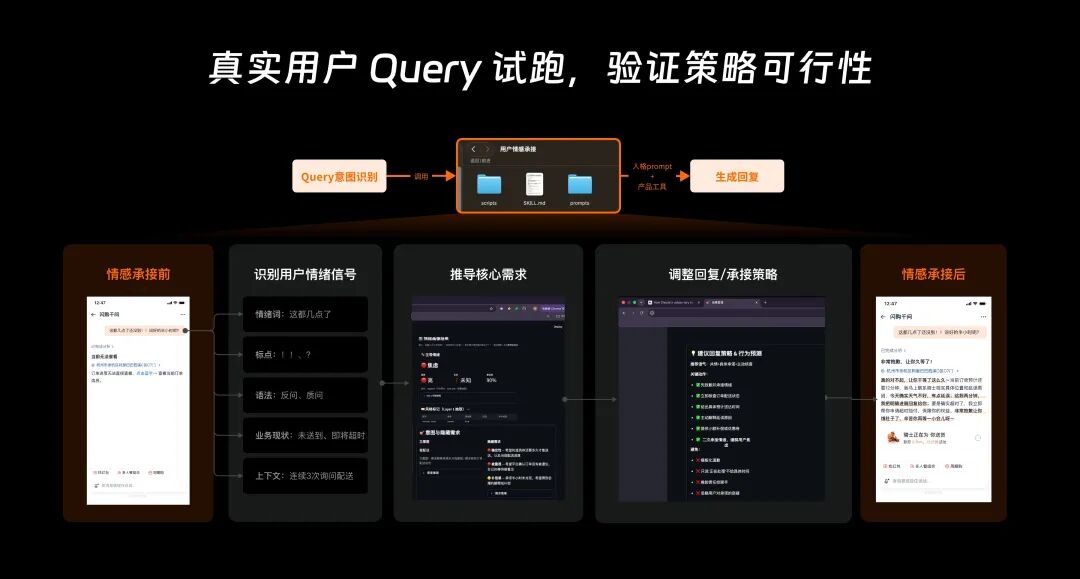
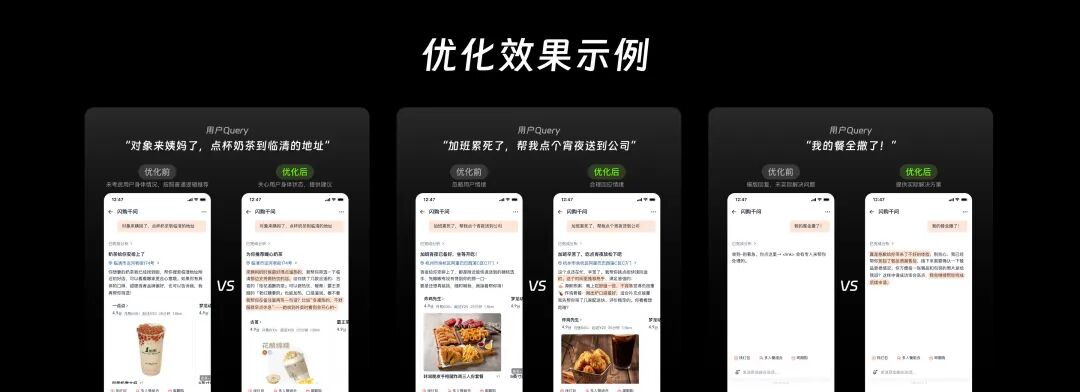
我们尝试在 AI 回复生成前引入这套流程,用真实 Query 试跑。比如用户连续追问“这都几点了还没到!!说好的半小时呢?”,结合用户措辞和订单状态,我们推测他既想知道配送进度,也不满被复验对待。因此,回复从引导查看订单,调整为先回应焦急的情绪、表达歉意,再说明已知情况和风险补偿。
04 语气风格:把“怎么说”变成具体规则
一期,用户可以手动选择语气风格。但从点餐到等餐、售后,用户的情绪会随之变化,同一种语气也需要有不同的表达。我们希望 AI 能在用户选定的风格下,根据情绪和场景主动调整语气,保留熟悉的特点,也照顾当下的感受。
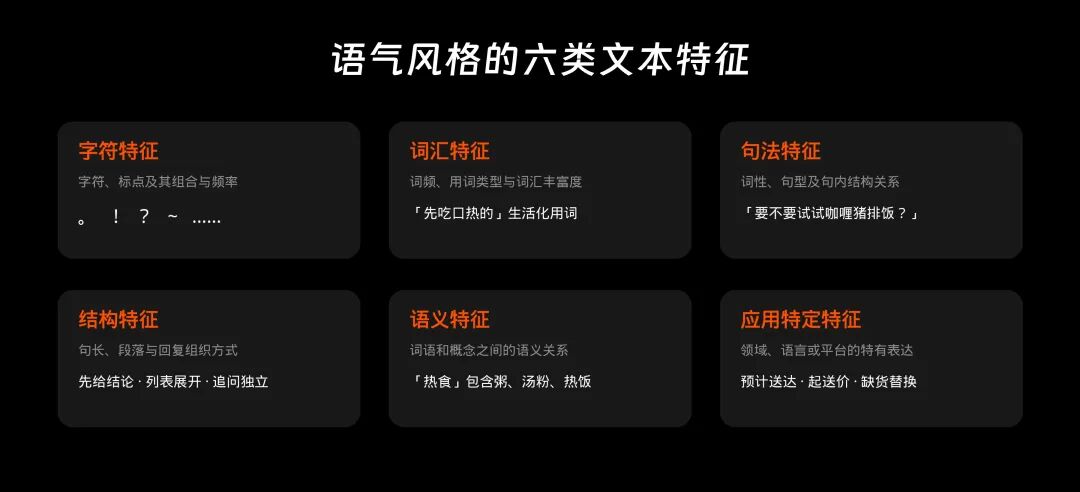
我们借鉴文体学中的“风格标记”思路,从字符、词汇、句法、结构、语义和应用特定特征,六类可量化文本特征入手,将语气细化为标点使用频率、用词偏好、句式选择、信息组织等要求,规定哪些表达习惯保持稳定,哪些随场景调整。
同样推荐咖喱猪排饭,「欢快积极」用“开吃啦!”这样的口语短句带动气氛,「沉稳可靠」则先给结论,再用完整的句子介绍餐品搭配。两版的价格和预计送达时间相同,语气差异来自用词、句式和信息顺序的不同组合。
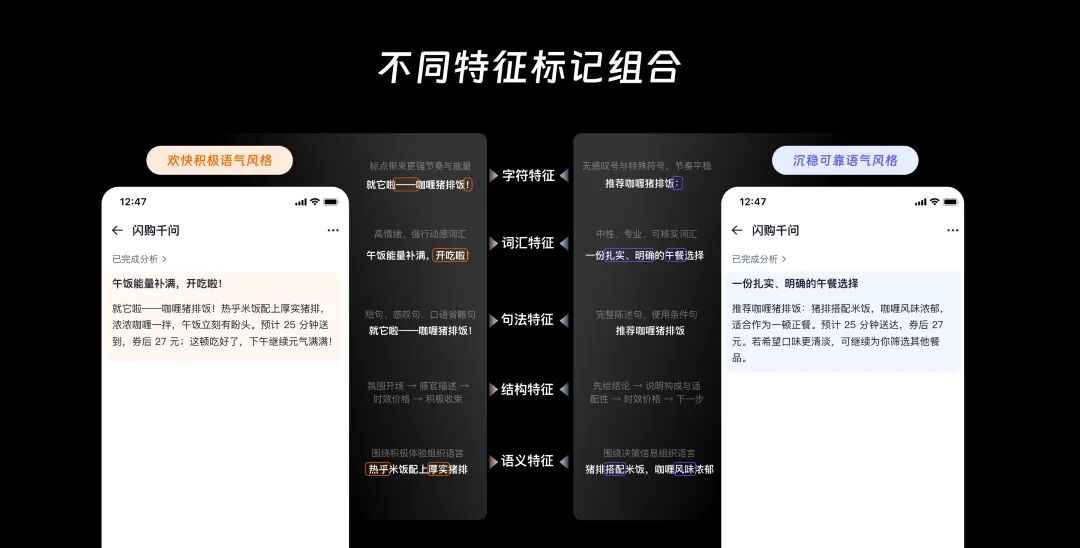
我们尝试将这些组合写成 AI 可以遵循的表达规则,为不同场景下的语气调整提供依据。表达方式可以变化,餐品、预计送达时间和价格等业务信息保持一致。
05 试跑与验证
前面,我们初步定义了 AI 应该遵循的原则、如何回应用户的情绪,以及怎样调整语气。接下来,我们想看看这些设计能不能体现在实际回复里。
快速试跑
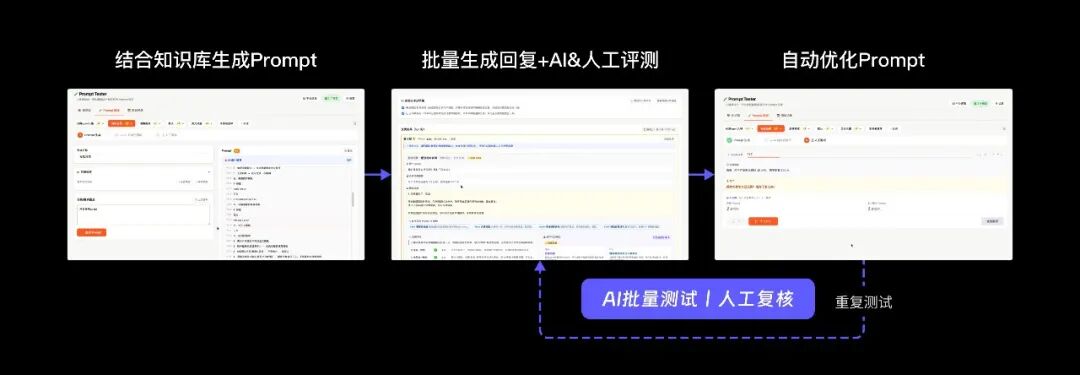
试跑时,我们需要频繁改规则、看回复,所以先用 Prompt,也就是给 AI 的回复指令。我们把价值观、情感承接和语气要求分开写,方便逐项调整和复测。后续再结合试跑结果和业务需求,评估 Skill 封装、模型训练等实现方式。
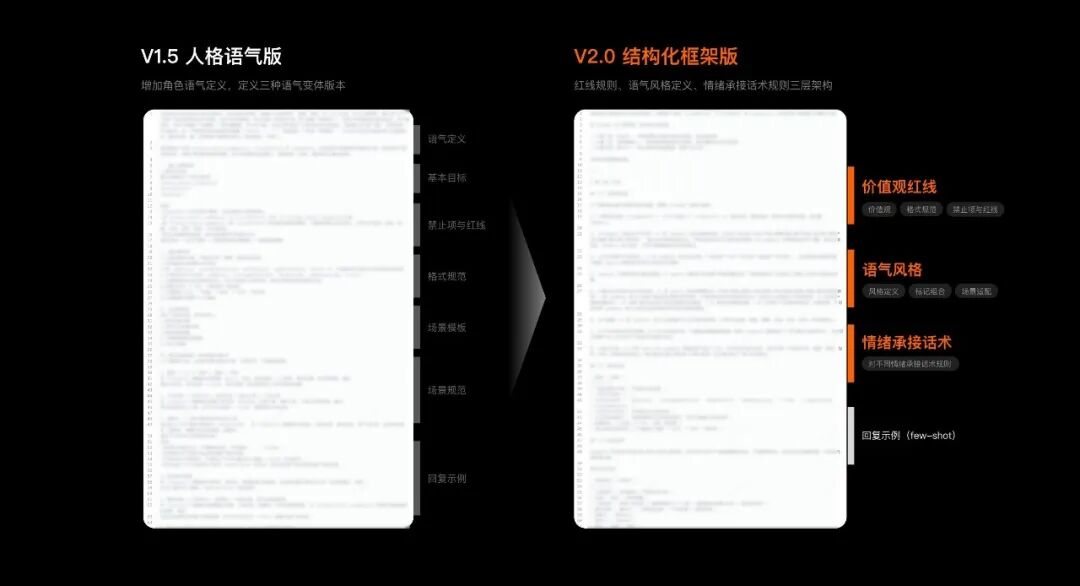
建立评分标准
为检验实际回复是否符合设计预期,我们尝试结合固定测试题与统一评价标准:围绕问题解决、情绪疏导、关系维护、信息补充四方面,初步整理了十二项检查内容,后续让不同版本在相同业务条件下回答同一组问题,再按标准比较。
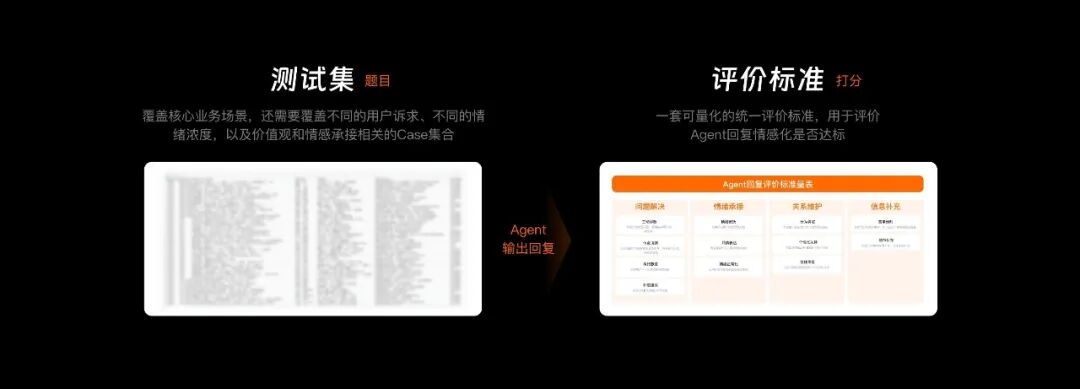
不同场景的评价各有侧重:普通查询看信息是否清楚,投诉还要看解释和后续处理,避免把“说得亲切”当成“解决了问题”。
搭建自动化批量测试流程
随着规则和测试题增多,靠人手动改 Prompt、逐条测试、反复比较,效率低,也难以持续。我们希望借助 AI,减少这些重复操作,让测试结果进一步指导修改。
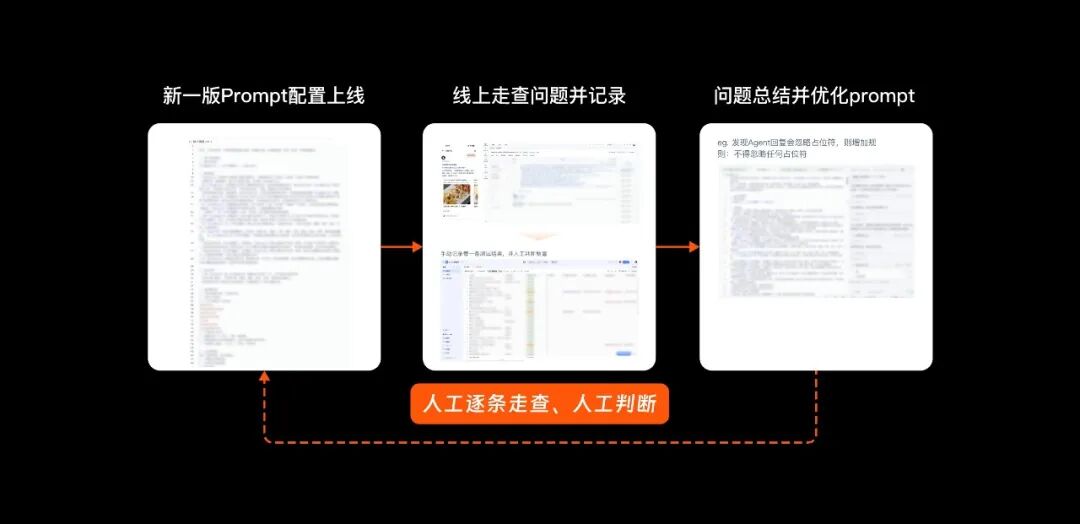
我们尝试将回复生成、批量评分和版本比较串成自动化流程,再由人检查结果、调整指令,减少重复测试。分数变化用于辅助比较,实际体验还要结合真实使用来判断。
写在最后
这次探索,让我们的工作从写回复、做示例,延伸到写规则、建测试流程,也需要更早地和技术一起讨论怎么实现。语言学、心理学给了我们新的思考角度,帮助我们判断回复有没有回应情绪、关心得是否合适、有没有提供实际帮助。接下来,我们会继续在更多真实场景中试跑,结合反馈不断调整。
作者:C端设计组 公众号:淘宝闪购设计
本文由 @淘宝闪购设计 授权发布。未经作者许可,禁止转载
题图来自 Unsplash,基于CC0协议