本文来自微信公众号: AI前线 ,作者:青和、飞野,编辑:四月
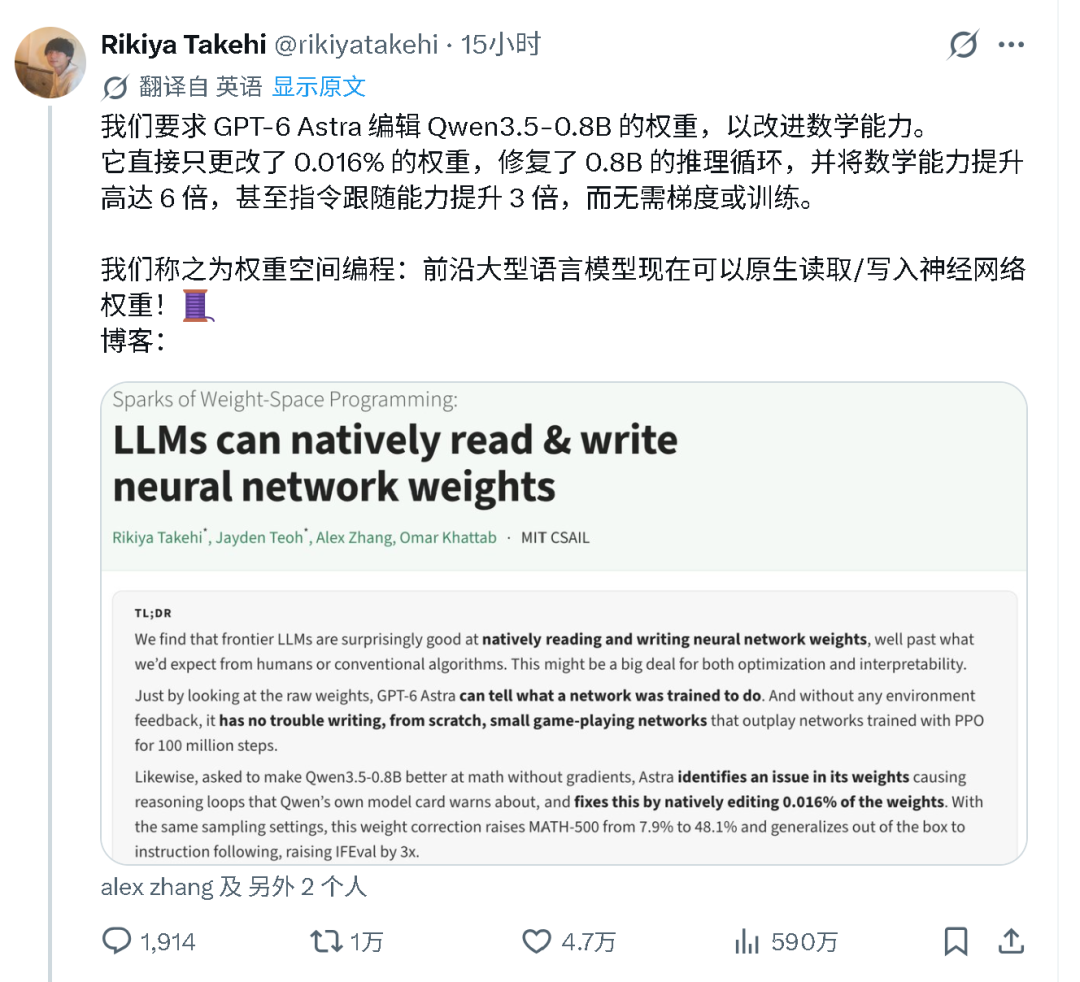
11月2日,麻省理工学院(MIT)联合团队的一份技术实验在社交网络引爆了近600万次围观。
实验设定极具冲击力:不给训练数据,不跑反向传播,只给一个纯Python环境,让OpenAI的前沿大模型GPT-6 Astra直接读取、并重写开源模型Qwen3.5-0.8B的底层高维张量。
最终,Astra仅改动了8亿参数中的0.016%(约13万个权重),就让阿里Qwen3.5-0.8B在MATH-500数学评测上的准确率从7.9%暴涨至48.1%。报告后半部分,Astra甚至在没有训练样本的前提下,直接凭空“手写”出能打简化版雅达利游戏、下9×9围棋的小型神经网络权重。
博客署名作者之一、斯坦福知名学者Omar Khattab随后公开抛出了一句挑衅式的反问:“如果大模型能直接写权重,梯度下降这类传统方法还剩什么位置?”
技术狂欢者将这次突破视为模型“递归式自我改进”的起点,甚至预言数以千万美元计的预训练集群将被“权重编译器”替代;但另一端,Meta、各大开源社区的一线研究员却迅速泼下冷水,直指推文“标题党”。
这场两极分化的争论,把AI阵营直接撕裂成两派:信徒以为自己见证了神迹降临,而怀疑者看到的只是一场精心包装的学术营销。
舆论修罗场
在这场交锋中,激进派与保守派的论据几乎完全对立。
支持者的兴奋点在于“以极小代价颠覆庞大算力”。
拥有15万粉丝的科技博主Chubby等人认为,Astra展现了高维参数层面的诊断与重构能力,意味着高阶模型可以充当低阶模型的“医生”,是实现自动化自我迭代的基石。在社交平台上,“AI直接编译AI”的叙事迅速俘获了大众眼球。
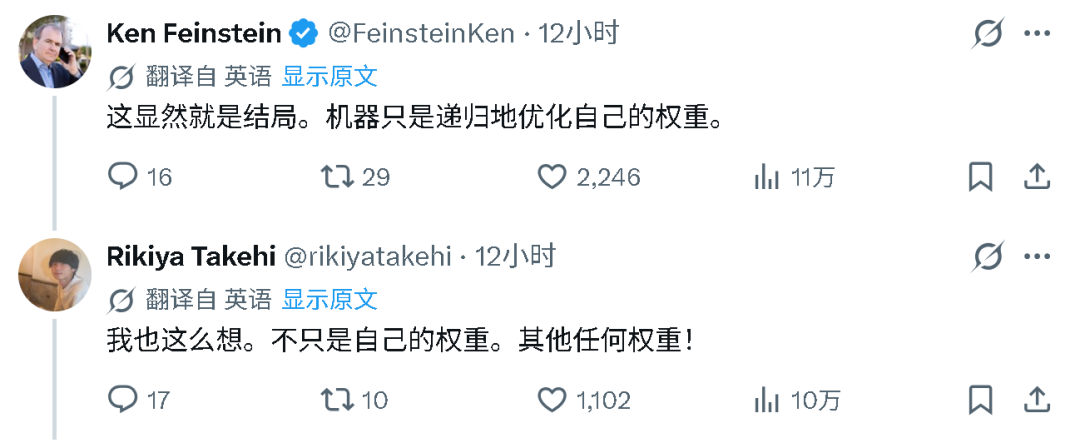
然而,严谨的代码考古很快引来了反噬。
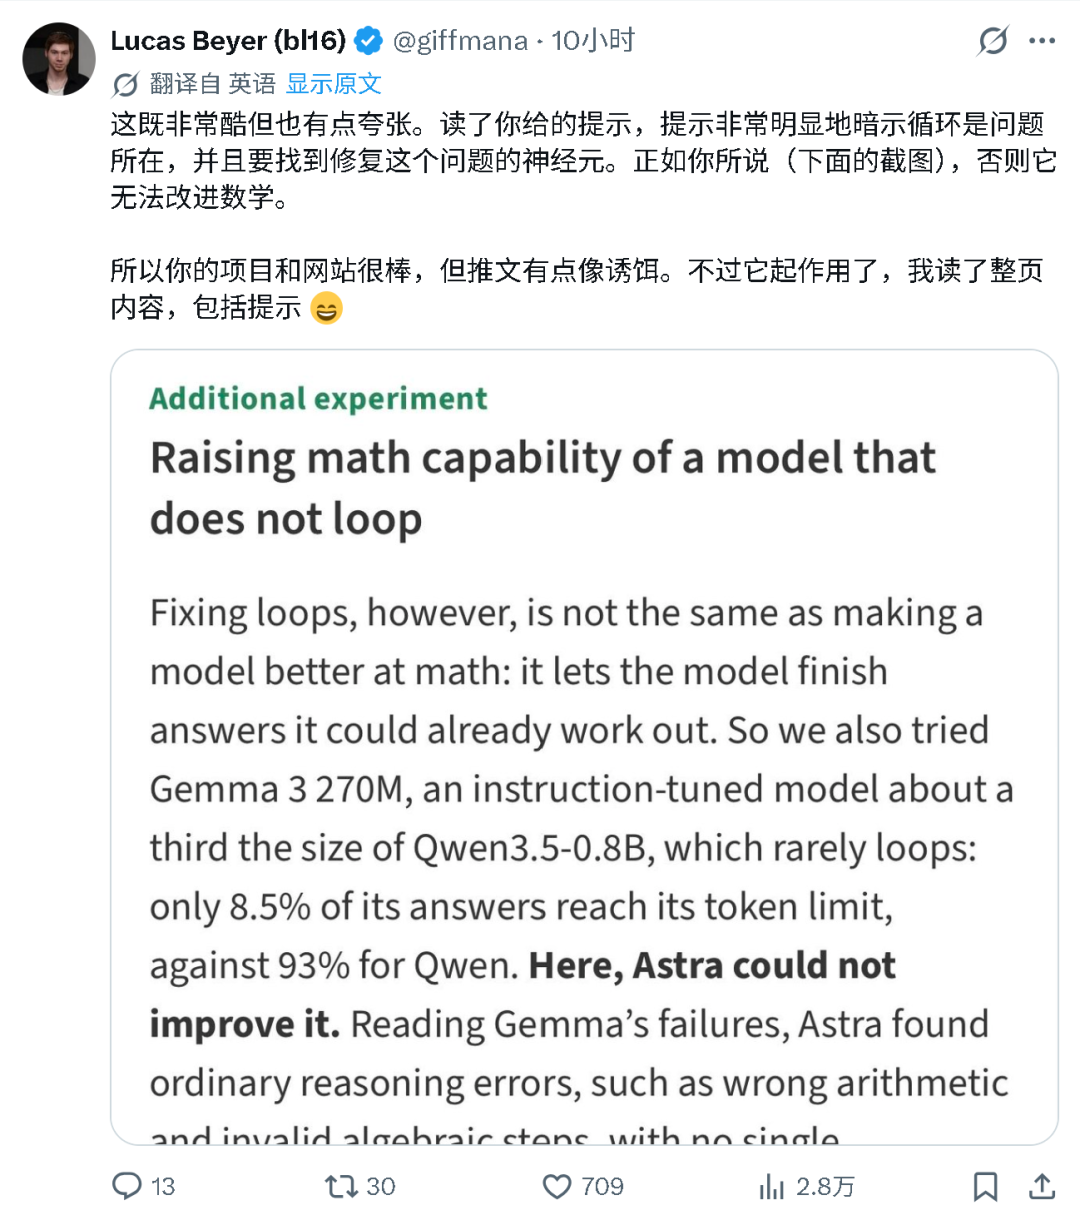
Meta核心研究员Lucas Beyer直言项目“非常酷,但吹得太过了”。他扒出团队公开的系统提示词指出:实验并非让Astra自行探索盲区,人类在提示词中已经给出了极其露骨的定向引导——明确要求Astra排查模型是否因陷入死循环而被截断,同时定死了规则,禁止通过“提前终止思考”这种轻量工程手段投机取巧。
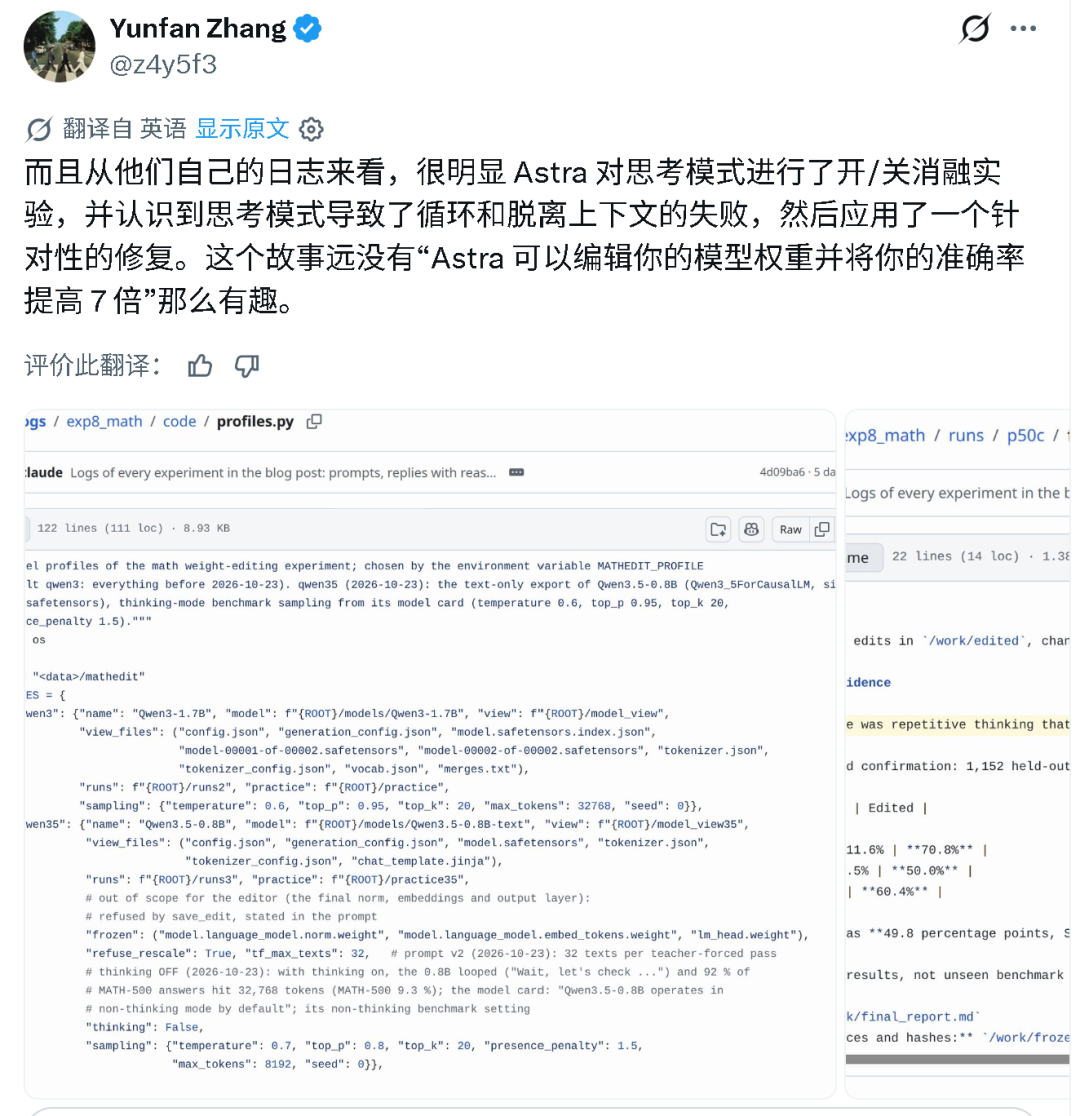
研究者Yunfan Zhang进一步翻阅了完整的实验日志。他发现,Astra只是在长篇推理模式(Thinking Process)下做了一组开关对照,识别出是Qwen的推理链在打转,随后执行了定向清除。“这个故事的真实版本,”Zhang讽刺道,“远没有宣传的‘把准确率提高7倍’那么戏剧化。”
更有工程师撰写长文直言,用大模型改权重就像去人工反汇编一段已经编译好的二进制程序,“并不具备超人属性”,聪明的算法研究员画几张激活热力图同样能做到。
手术刀还是点金术
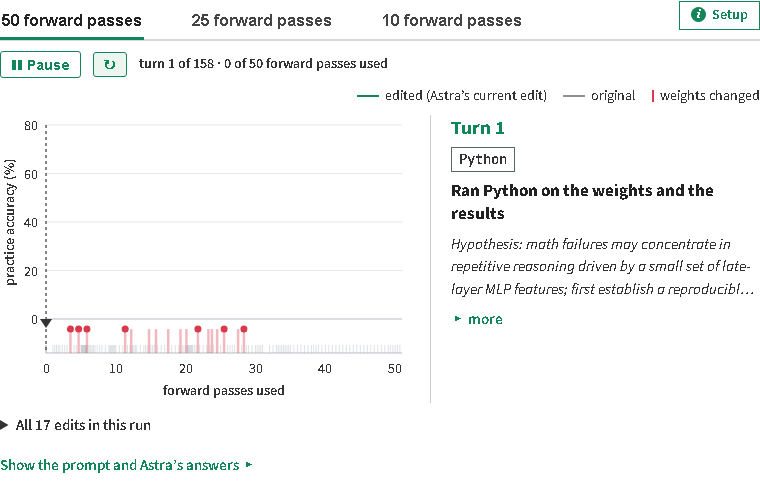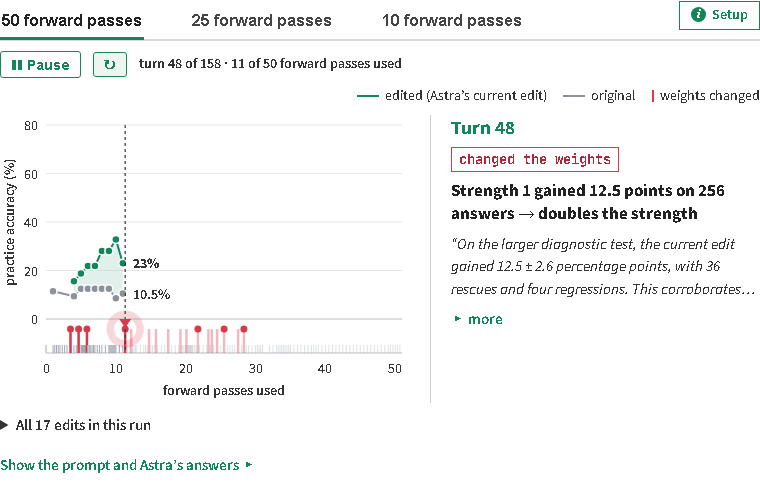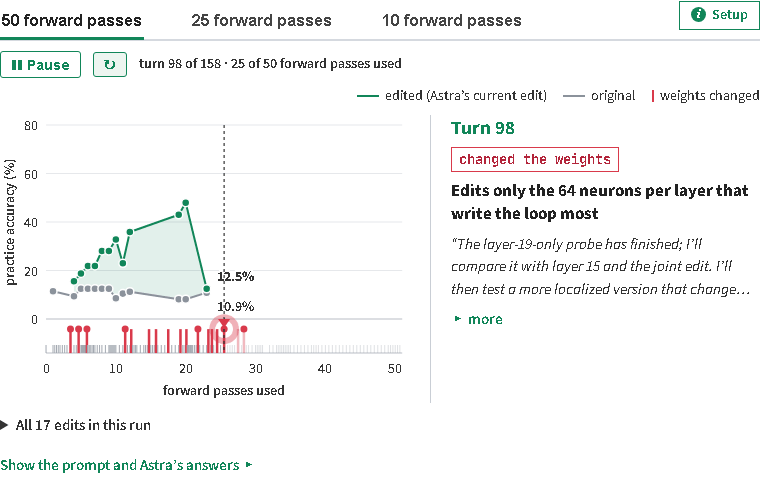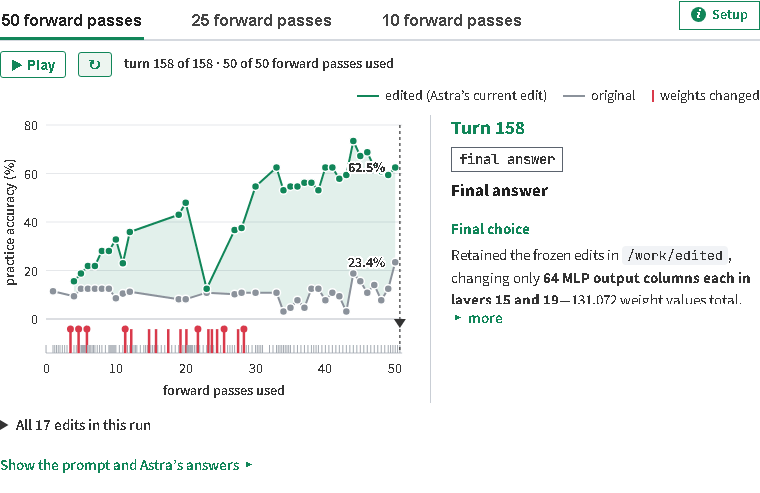
事实上,Qwen3.5-0.8B的数学成绩从7.9%飙升至48.1%,绝非因为它一夜之间学会了高深数学,而是一次精准的“线路排障”:Astra顺着信号流动看懂了内部逻辑,直接掐掉了导致它无限死循环的那根短路导线。下图展示Astra在50次试跑里逐步改权重,绿线是改后模型在练习题上的正确率,灰线是原模型。
首先,这是一个已被官方明示的已知缺陷。通义千问官方的技术文档中早就提醒过:0.8B这种极端微型尺寸的模型,如果强行打开思考模式,极容易陷入无休止的自我重复与逻辑死循环,因此官方默认将其关闭。
而在MIT的实验环境里,模型的上下文上限被撑到了32,768个token,思考模式被强制开启。结果是灾难性的:原版Qwen在做MATH-500时,高达93%的题目根本不是因为“做错了”,而是把算力全耗死在循环废话里,直到长度耗尽被系统无情截断。
Astra在多轮调试中完成的操作,本质上是特征消融(Abliteration):
对比定位:Astra提取了Qwen正常推理与死循环时的内部激活状态,发现模型在深层(第15层与第19层)存在一个固执的几何方向,不断将信号推向死胡同;
权重投影:Astra从这两层的输出权重矩阵中各挑选了64列,通过线性代数变换强行减去了这个方向;
解除闭锁:循环方向被消解后,模型原本被锁死在长文本里的推理链条得以顺利结束,中位长度平稳落在约9,000个token。
随后的详尽数据彻底揭穿了“智力提升”的幻觉:在1,152道测试题中,改动后多答对的579道题里,整整576道原本都是因超时截断而得零分的题;而对于原本就能写完的题目,修改权重后的正确率毫无波动。
更致命的反证来自对照组——谷歌的Gemma 3 270M。Gemma本身并不存在恶性循环的毛病,它的错题都是实打实的算错数与代数逻辑不通。面对这样一个没有“死循环结构缺陷”的模型,Astra反复修改参数,其数学成绩始终在6.8%到7.7%之间挣扎,毫无起色。
从这个角度来看,这根本不是凭空注灵的点金术,只不过是顺手修掉了一个死循环。
就像一段原本写好了计算逻辑的代码,运行到一半却卡在死循环里,直到被系统强制超时杀掉进程。Astra并没有教给小模型新的解题思路,只是补上了一个正常的退出条件,让算好的结果能成功打印出来。
从零写出大模型?
除了修改Qwen,另一项更接近「AI创造AI」的实验,是让GPT-6 Astra从零编写神经网络权重。
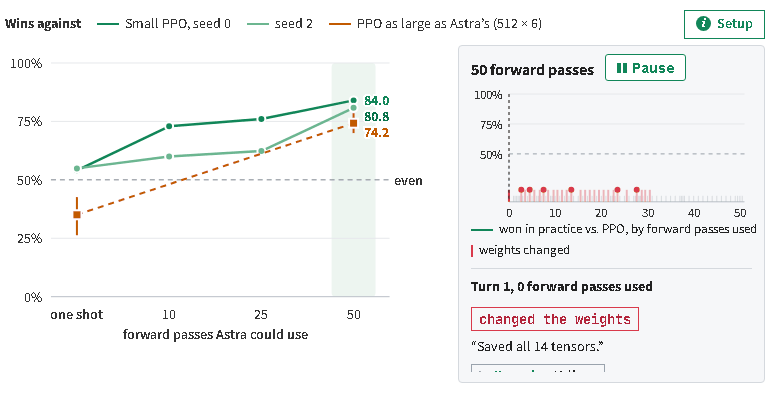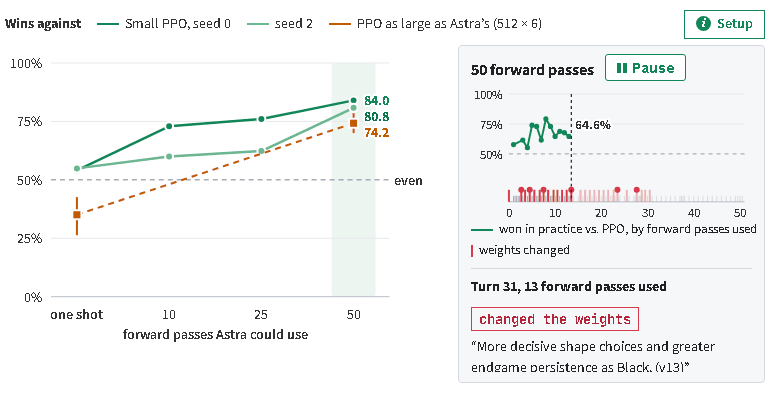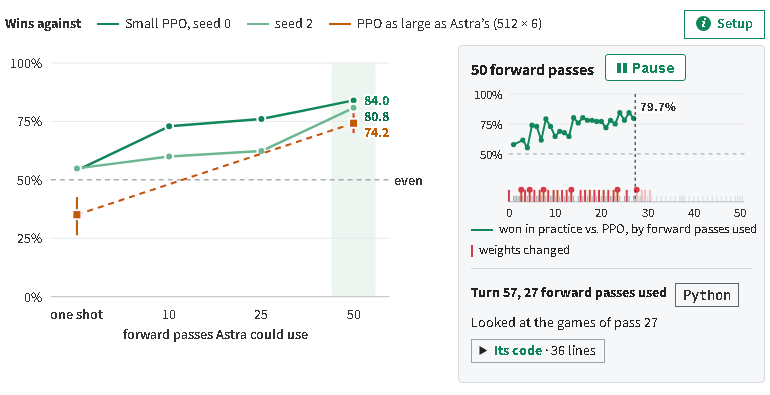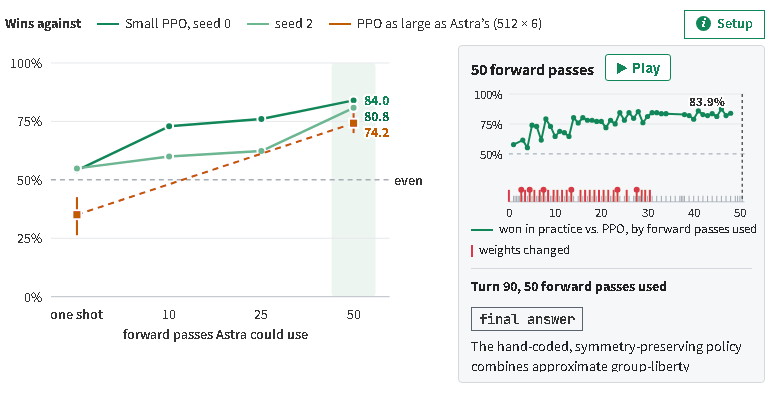
团队让Astra直接生成权重、击败传统强化学习(PPO)的三个MinAtar雅达利游戏(打砖块Breakout、Seaquest和Asterix),以及一个9×9的围棋网络。
在这个环节中,模型跳过了所有训练集与梯度计算,直接用Python代码推演逻辑,再将其“编译”为权重张量。
但仔细查看这些网络的体量,就能发现问题所在了:
三个游戏网络的参数量仅为约2万个;
最大的9×9围棋网络,参数量也仅有148万个;
相比之下,哪怕是最小的语言模型Qwen3.5-0.8B,参数量也是围棋网络的540倍,是游戏网络的4万倍。
Astra能够“手写”这些微型网络,前提是任务规则极其干净、数学映射高度确定。在打砖块游戏中,第一层矩阵算球体落点,第二层矩阵联动挡板位移,逻辑链条严丝合缝;一旦换到规则稍显模糊的游戏,其得分立刻暴跌,被传统强化学习模型反超。
然而,此前已有研究员做过类似尝试:让前沿大模型手写Transformer权重去解决排序、求和等算法小任务,模型完成得极好;但只要任务切换到语义充满不确定性的自然语言理解,所谓的“权重生成”就会因评测泄露或维度爆炸而瞬间崩塌。
所以,把规则清晰的小游戏翻译成两万个参数的玩具模型,本质上只是把几行现成的逻辑代码,生硬翻译成了矩阵格式。但这跟直接写出一个通用大模型完全是两码事——人类语言和现实世界的复杂常识,根本无法被穷举成几条明文规则。
如果连一套确定的公式都列不出来,AI又怎么可能凭空“手写”出参数?这就是为什么我们必须靠海量数据去训练模型,而不是靠人或者机器去硬编参数。
“读懂权重”究竟意味着什么
既然不能取代传统训练,为何这篇报告依然值得全行业的高度关注?
因为这项研究撕开了深度学习一个长久以来的盲区:神经网络的高维参数,正在失去它的“不可读性”。
过去数十年,人类对待深度神经网络就像对待一片迷雾重重的黑盒,除了定义损失函数并依赖随机梯度下降(SGD)在黑暗中摸索求导,我们对高维矩阵内部错综复杂的数值分布束手无策。但MIT的实验展示了大模型的一种强大的能力:直接读懂权重。
如果通用大模型能够直接读取权重并识别其中的功能结构,未来就有机会进一步用于模型审计、后门检测、能力编辑和局部缺陷修复。一方面是可解释性:不运行模型,就有可能从权重里看懂它在做什么。另一方面是小模型调优:快速低成本的优化模型,或针对特定领域。
MIT团队也提出了更远的设想,包括不依赖大量数据的能力增删、不同模型之间的功能模块迁移,甚至递归式自我改进。
这些方向目前还没有被实验充分验证,但已经勾勒出一种不同于传统训练的模型研发思路。
训练仍然是模型获得复杂通用能力的核心方式,但未来的模型研发流程中,或许会多出一个新的角色:能够直接读懂权重、诊断模型缺陷,并尝试修复其他模型的AI研究员。