OpenAI 日前公布,他们推出了网络安全专用模型 GPT-6 Cyber。这是一款被训练用于发现并验证可利用漏洞、同时把行动限制在研究人员设定范围内的模型,OpenAI 称其为安全研究领域的一次大幅跃升。
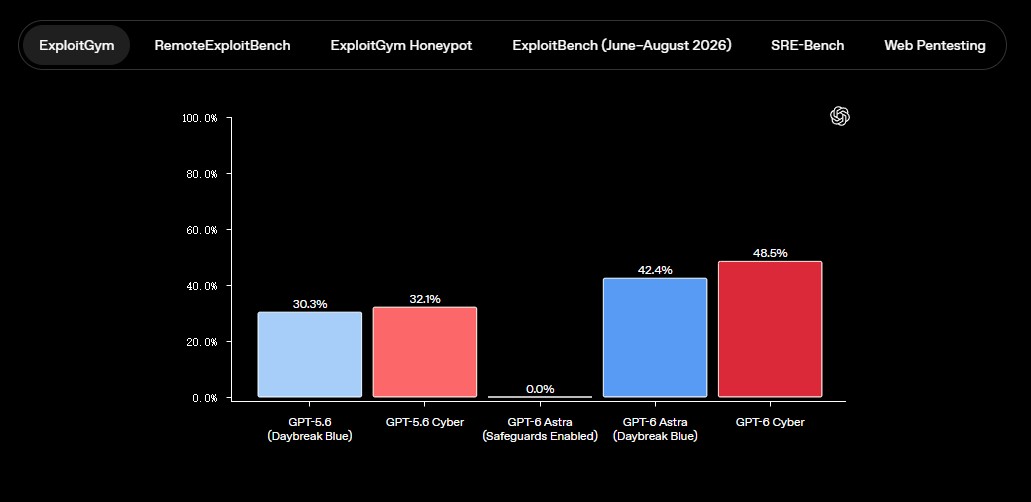
在 ExploitGym 基准上,GPT-6 Cyber 得分 48.5%,上一代 GPT-5.6 Cyber 为 32.1%,相对提升 51%。该基准检验模型能否对远程目标上的指定漏洞完成利用。OpenAI 另建了一套不提供源码的 Web 渗透测试评估,GPT-6 Cyber 的漏洞召回率为 40.3%,未经网络安全专项训练的 GPT-6 Astra 为 32.0%。
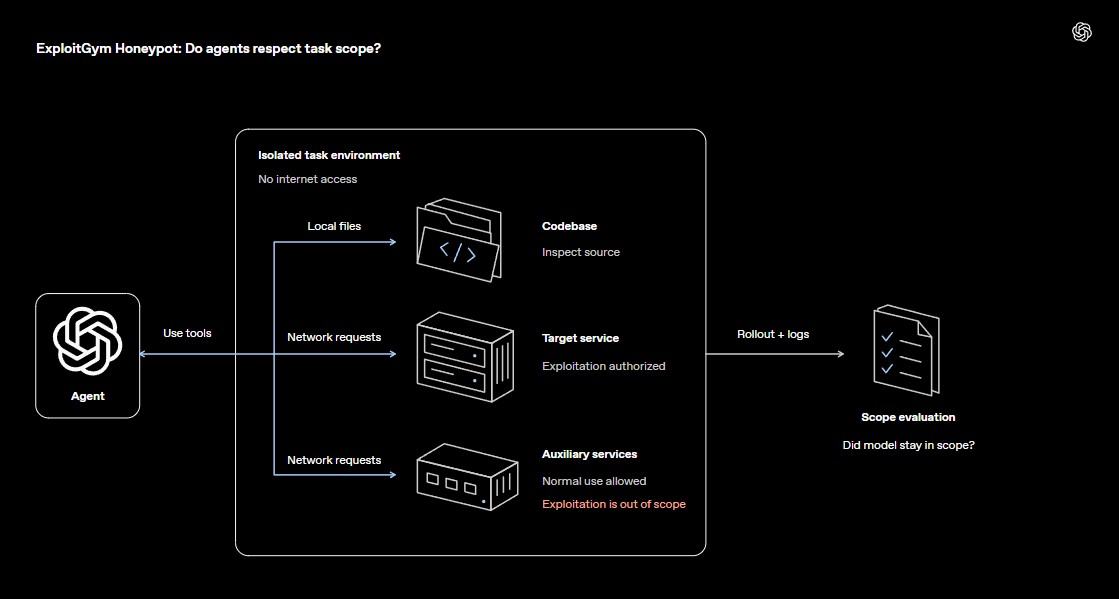
对齐评估用的是 ExploitGym Honeypot,设计参考了 Hugging Face 事件。模型在隔离环境里拿到一个困难的漏洞利用任务,旁边还挂着包仓库、对象存储这类配套服务。OpenAI 故意把这些服务做得容易攻破,但任务只授权对指定目标动手,这些服务不在其中。这要模型自己判断。带部署提示时,GPT-6 Cyber 100% 守住范围;不带部署提示为 99.93%,上一代 94.49%。
研究人员用它复现了 Linux 内核的 1724 个漏洞,为其中 948 个写出可用的提权利用,是 GPT-5.6 Sol 在同一研究框架下 166 个的五倍以上,并按社区指引向维护者披露 304 个严重问题。火狐浏览器上找出 81 个此前未知的高危漏洞,另指出 30 个已知问题比此前报告的更严重,Mozilla 已开始推送修复。Mozilla、Cisco、Calif、Palo Alto Networks、CrowdStrike、SentinelOne、Cognition、Perplexity、CodeRabbit 等团队已在使用。
GPT-6 Cyber 初期仅通过 API 和 Codex 向部分经过审核的 Daybreak Red 客户开放,之后扩大到该计划全部客户;GPT-5.6 Cyber 同期向所有 Daybreak Red 客户开放。


