在 Agent 推理负载快速增长的背景下,传统面向聊天场景的推理引擎正面临吞吐优化目标失效、缓存利用率不足、硬件适配滞后等一系列结构性挑战。
本文整理自 TokenSpeed 独立贡献者尚旭春在 AICon 2026 深圳站的分享《构建面向 Agentic 推理的下一代 LLM 推理引擎》。他系统介绍了该项目从立项到版本迭代的完整技术路径,围绕 Agent 场景下的工作负载特征、分层解耦的系统架构、自动并行编译系统、KV Cache 演进路线、Kernel 优化策略以及跨平台抽象设计展开,并给出在 Blackwell 平台上的阶段性性能数据。
以下是演讲实录(经 InfoQ 进行不改变原意的编辑整理)。
为什么 Agentic 推理需要新推理引擎
TokenSpeed 立项之初,我们首先要回答的问题是:为什么 Agent 场景需要一套全新的推理引擎设计。
传统 Chat 类负载的优化目标相对单一,用户发起一次请求,模型一次性生成一段完整回复。在这种模式下,推理系统只需要尽可能将 batch 打满、最大化吞吐,KV Cache 在一次加载之后就被释放,利用率天然偏低。但 Agent 场景的负载特征与 Chat 有本质区别。以 coding agent 为例,模型需要持续地思考、调用工具、获取结果、再基于结果继续思考,整个过程由多轮短请求循环构成。第一次请求可能携带几十 K 的前缀上下文,但后续每次循环的输出往往只有几百个 token。这意味着推理引擎必须重新审视缓存复用策略、请求调度机制以及整个系统的优化目标函数。
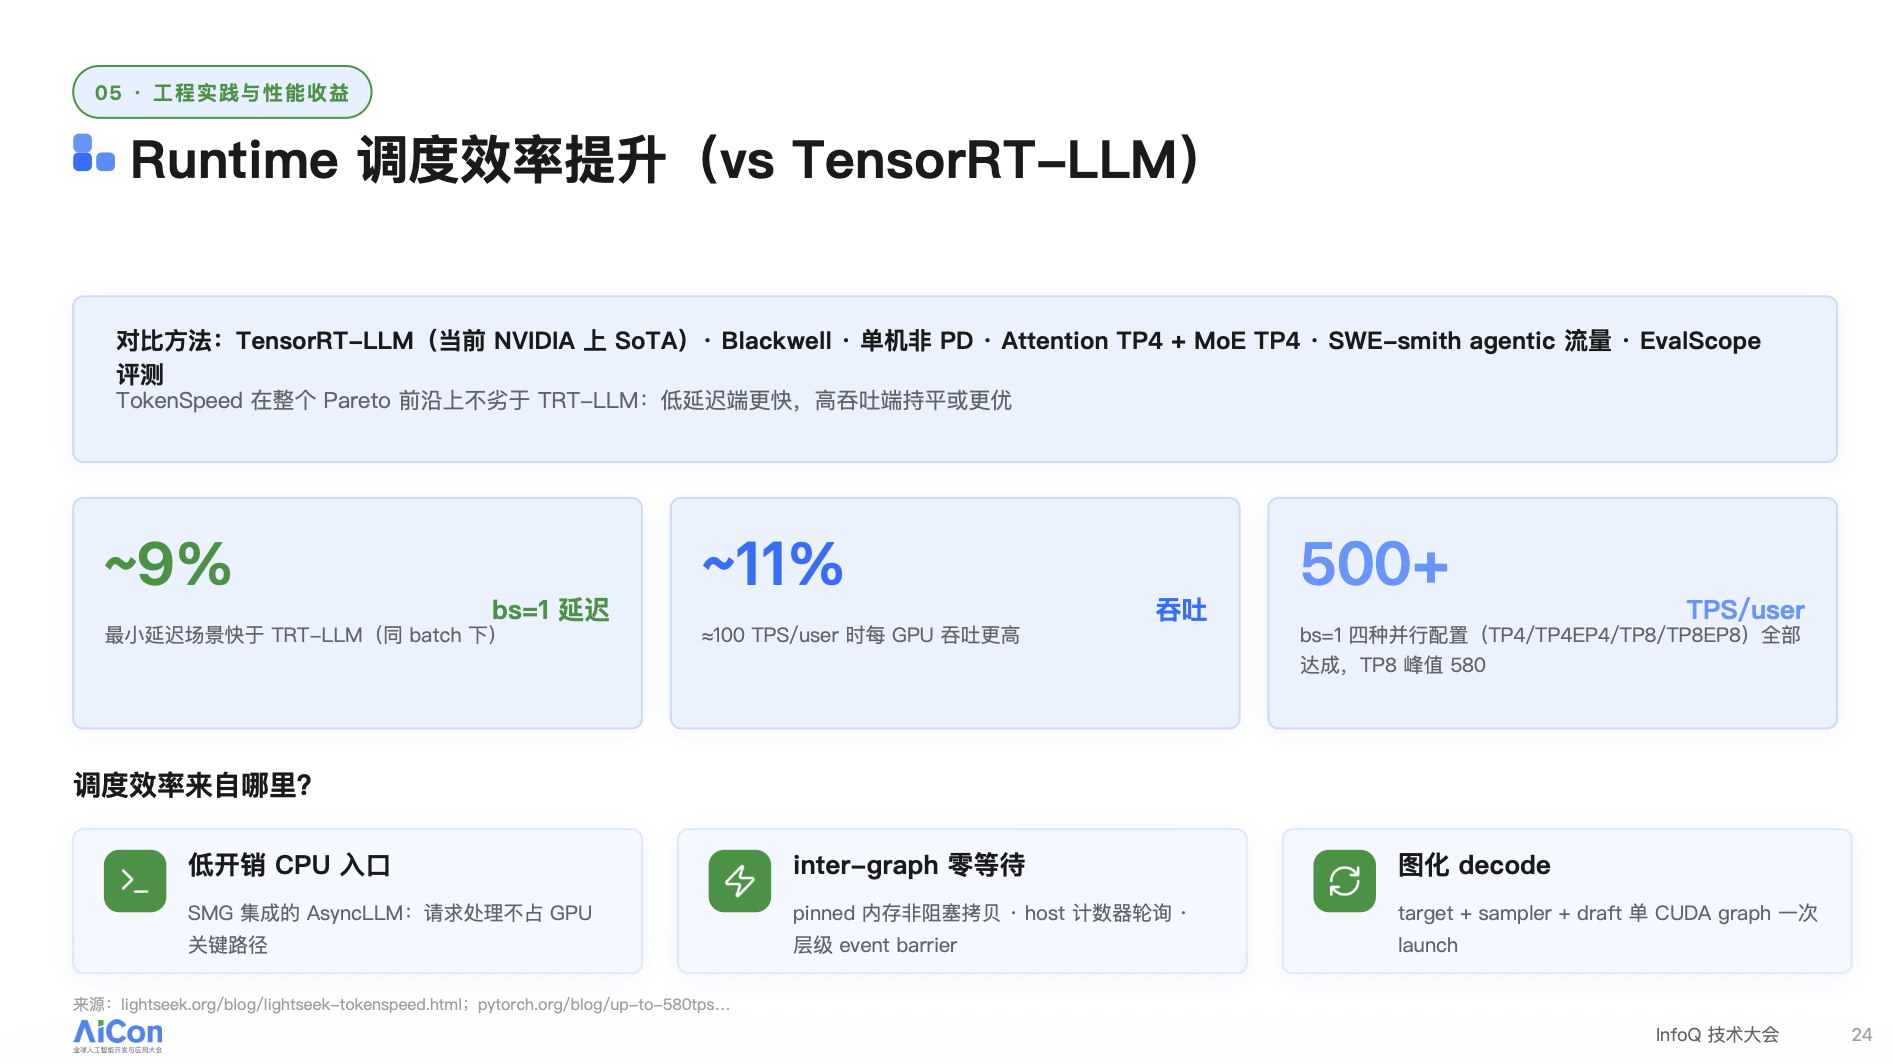
在这种负载形态下,用户对延迟的敏感度显著提升。如果一个 Agent 工具在推理环节出现显著滞后,用户会直观地感受到“跟手性”不足。因此,Agent 场景下真正需要优化的是延迟约束下的吞吐。我们内部定义了一个性能指标:每用户 TPS 不低于 70,在此约束下尽可能提升每个 GPU 的吞吐能力。以 TensorRT-LLM 为对比基准,TokenSpeed 在 batch size 等于 1 的最小延迟场景下,端到端延迟比 TensorRT-LLM 快 9%;在每用户 100 TPS 的典型工作点上,每个 GPU 的吞吐高出 11%。
KV Cache 复用率是决定推理成本的关键变量。以 DeepSeek 为例,其缓存复用率据称在 99% 以上,而业界多数系统目前只能达到 70% 到 80%。在 Agent 场景下,同一段几十 K 的上下文如果能够被反复命中,意味着每次命中都能完全省去 prefill 计算,系统的整体成本会大幅下降。我们在测试中验证了 TokenSpeed 在上下文长度从 128K 扩展到 1M 时的表现,解码吞吐率仅下降 16%。此外,随着越来越多的模型采用线性注意力机制,包括千问的 Gated DeltaNet 以及 Kimi K3 所使用的 KDA,KV Cache 的管理模式也在发生变化。线性注意力模型不再维持传统的 token 到 KV 的一一对应关系,而是通过一个持续迭代的状态来表示上下文,其中包括 SSM 状态和卷积状态。如何在推理引擎中高效地更新、保存和恢复这些状态,是一个新的系统设计命题。
模型架构与硬件特性之间的耦合也在同步加深。MOE 架构自 DeepSeek 发布以来已经成为主流选择,但 MOE 模型的优化难度并不低。以 Kimi K3 为例,该模型有 896 个专家,虽然采用了 Latent MOE 技术将写成本大幅降低,激活专家的比例提升到了 16%,但路由和通信的复杂度显著增加。与此同时,Blackwell 这一代硬件引入了 Tensor Memory、新一代 Tensor Core 等一系列新特性,AMD 的 CDNA 架构也有其独特的硬件能力。如果推理引擎无法充分利用这些硬件特性,Blackwell 相对 Hopper 的性能优势就无法真正释放。基于这些观察,TokenSpeed 在 Kernel 层面针对 Blackwell 做了深度优化,确保硬件潜力被充分挖掘。
Runtime 与 Kernel 的协同设计同样不可忽视。调度器设计得再好,如果底层 Kernel 存在性能瓶颈或者耦合过深,系统整体仍然无法达到理想状态;反过来,Kernel 优化得再极致,如果调度器产生大量 bubble,吞吐也无法打满。TokenSpeed 在架构设计上吸取了这方面的经验,将调度、执行和底层算子做了系统性的解耦与重构。
Runtime:构建可扩展的推理引擎架构
TokenSpeed 的整体架构分为三个层次:控制、Runtime 和 Kernel。控制面完全使用 C++ 编写,Runtime 使用 Python 实现,Kernel 则独立为一个子包。这种分层设计的核心目的是保持模块边界的清晰性。控制面只负责调度决策,不涉及任何数据面的执行;Runtime 只负责执行控制面下发的执行计划,包括缓存计划和前向计算计划;Kernel 层则专注于算子实现。三者各司其职,避免了过去推理引擎中调度逻辑、执行逻辑和算子实现相互渗透导致的维护困境。
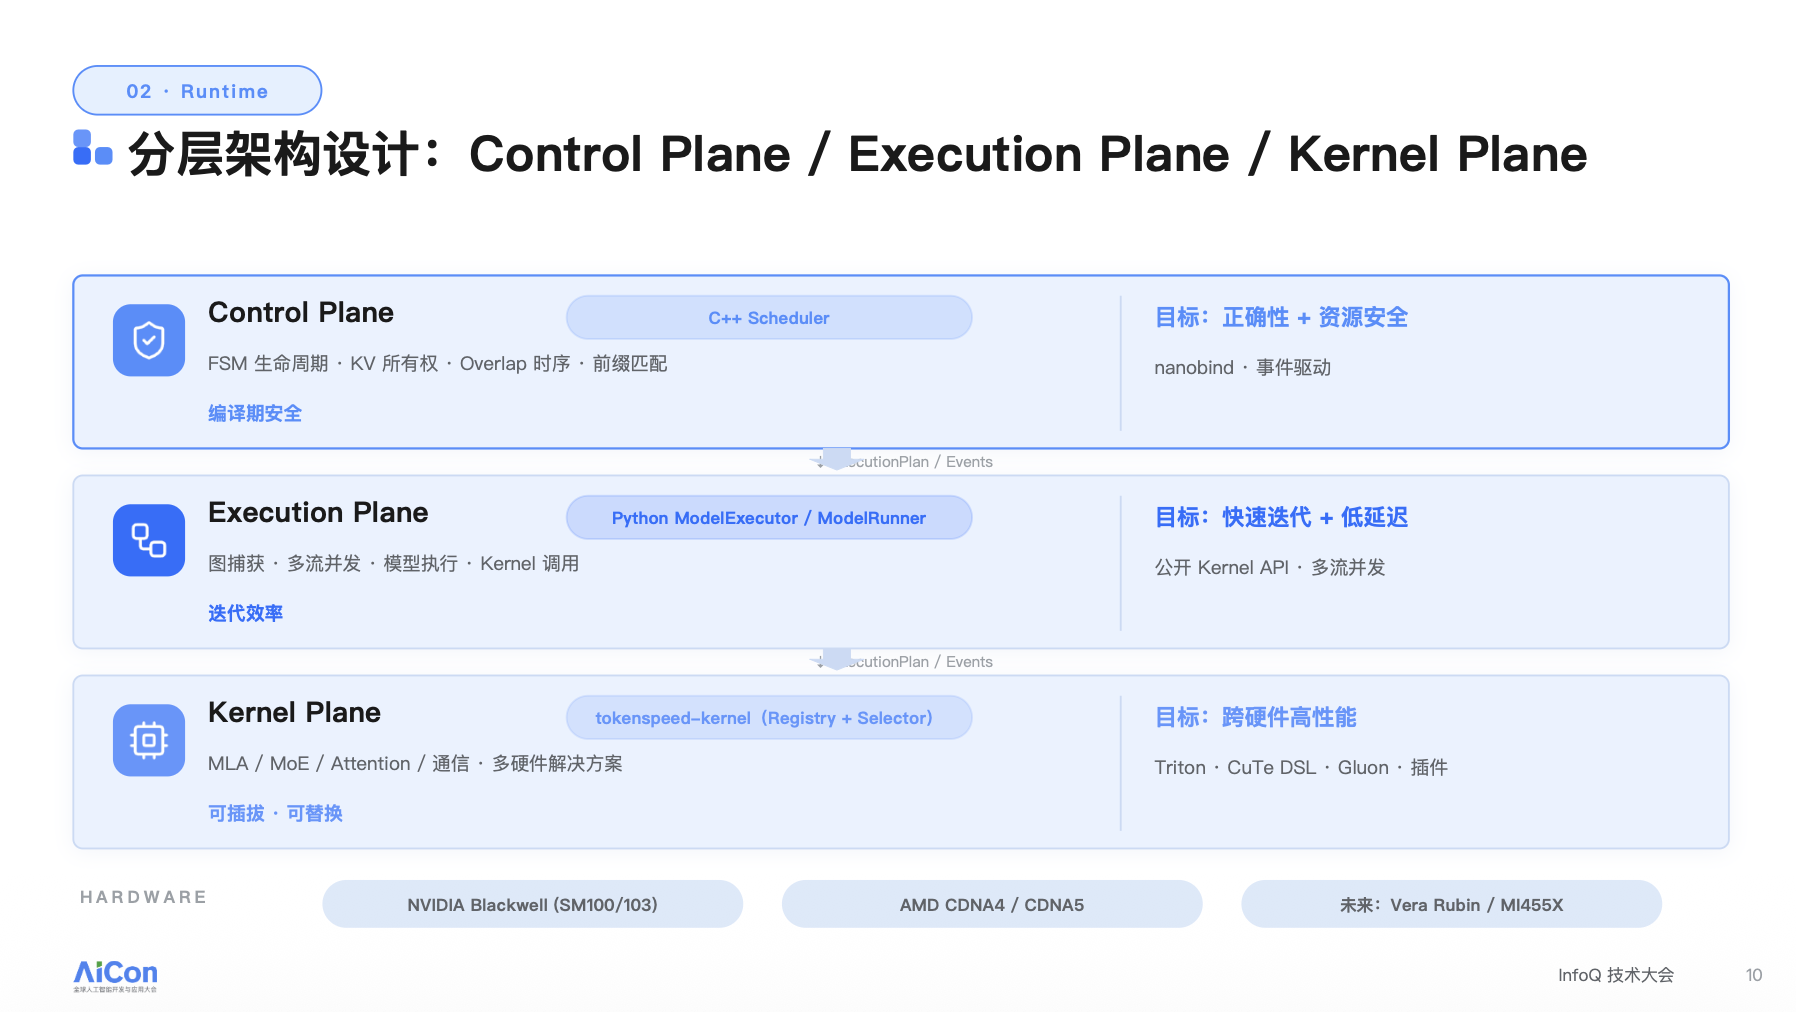
控制面选择 C++ 而非 Rust,有实际的历史原因。团队成员大多来自上古时代,对 Rust 的熟悉程度有限,C++ 在性能和表达力上完全满足需求,因此最终确定使用 C++ 进行控制面的程序设计。Runtime 保留 Python,则是因为 Python 生态在深度学习领域已经非常成熟,PyTorch、CUDA 等库的集成度高,模型适配层的开发效率远高于其他语言。Kernel 子包独立出来后,NVIDIA 和 AMD 的专家可以针对各自硬件特性做深度优化,而不需要理解调度器或 Runtime 的内部实现。
这种分层架构带来的另一个收益是并行编译的自动化。在过去的推理引擎开发中,模型并行切分的代码往往散落在各个模型适配模块内部,与注意力实现、MOE 实现、通信逻辑等深度耦合。随着支持的模型数量增加,这些散落的并行代码变得越来越难以维护,任何一个新模型的接入都可能牵动多个模块的改动。TokenSpeed 的做法是将并行切分逻辑从模型适配代码中完全抽离出来,形成一个独立的 Placement 系统。模型开发者只需要声明每个模块的边界、输入输出类型,以及该模块在并行维度的属性,是 replicate、shard 还是 partial,系统就会自动处理后续的切分和通信。
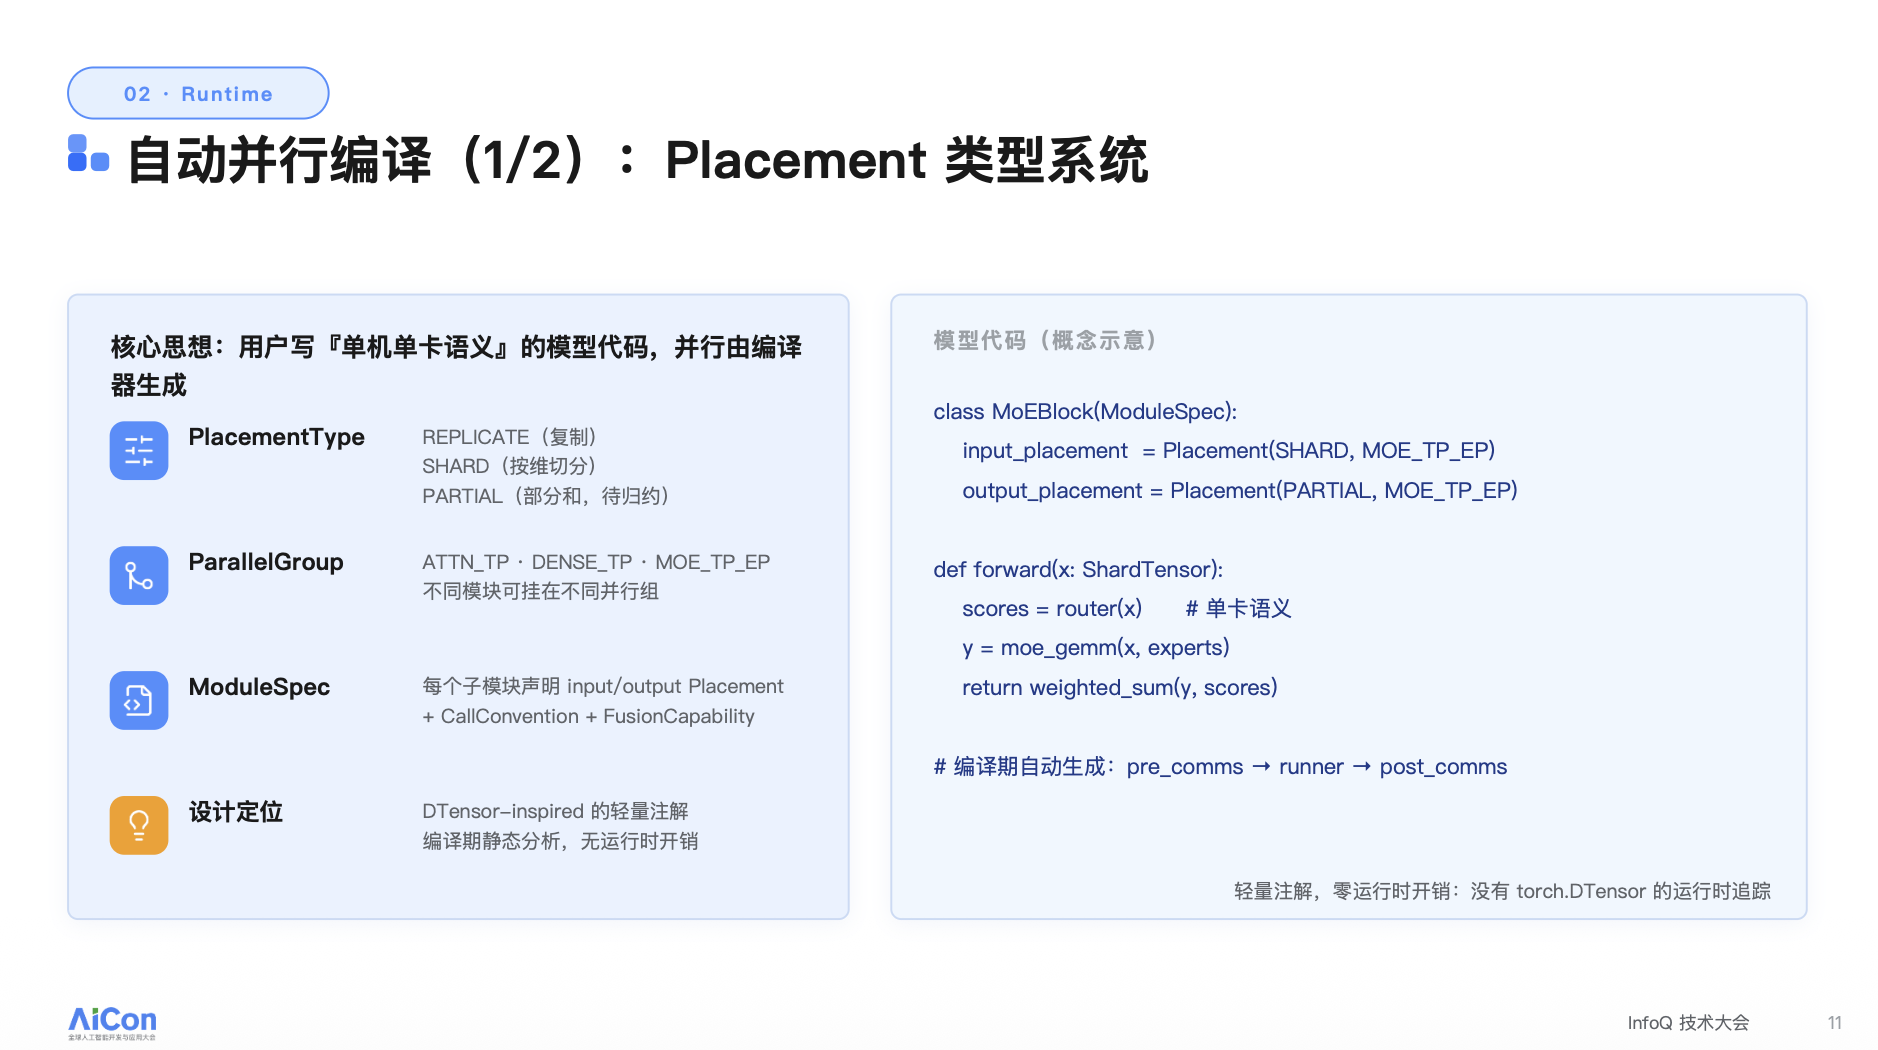
具体来说,每个模块可以挂载到不同的并行组上。注意力模块挂载到 Attention Tensor Parallel 组上,MOE 模块挂载到 MOE 并行组上,各模块独立选择并行策略。基于这些 Placement 定义,TokenSpeed 的类型编译系统会遍历整个解码层的执行计划,比较相邻模块之间的 Placement 差异。当发现不一致时,系统自动插入相应的通信原语:从 partial 到 replicate 需要 all-reduce,从 shard 到 replicate 需要 all-gather,从 shard 到 partial 需要 reduce-scatter。整个编译流程的输出是一个统一的 compiled_decoder_layer 执行计划,在运行时分为三个阶段接入:prefill 阶段做前置通信对齐,然后执行模型算子,最后执行通信输出。这种自动化的并行编译不仅大幅降低了模型适配的维护成本,还因为类型系统提供了前置信息,使得相邻算子之间的 fusion 成为可能,减少了 kernel launch 的开销,在性能上也有正向收益。
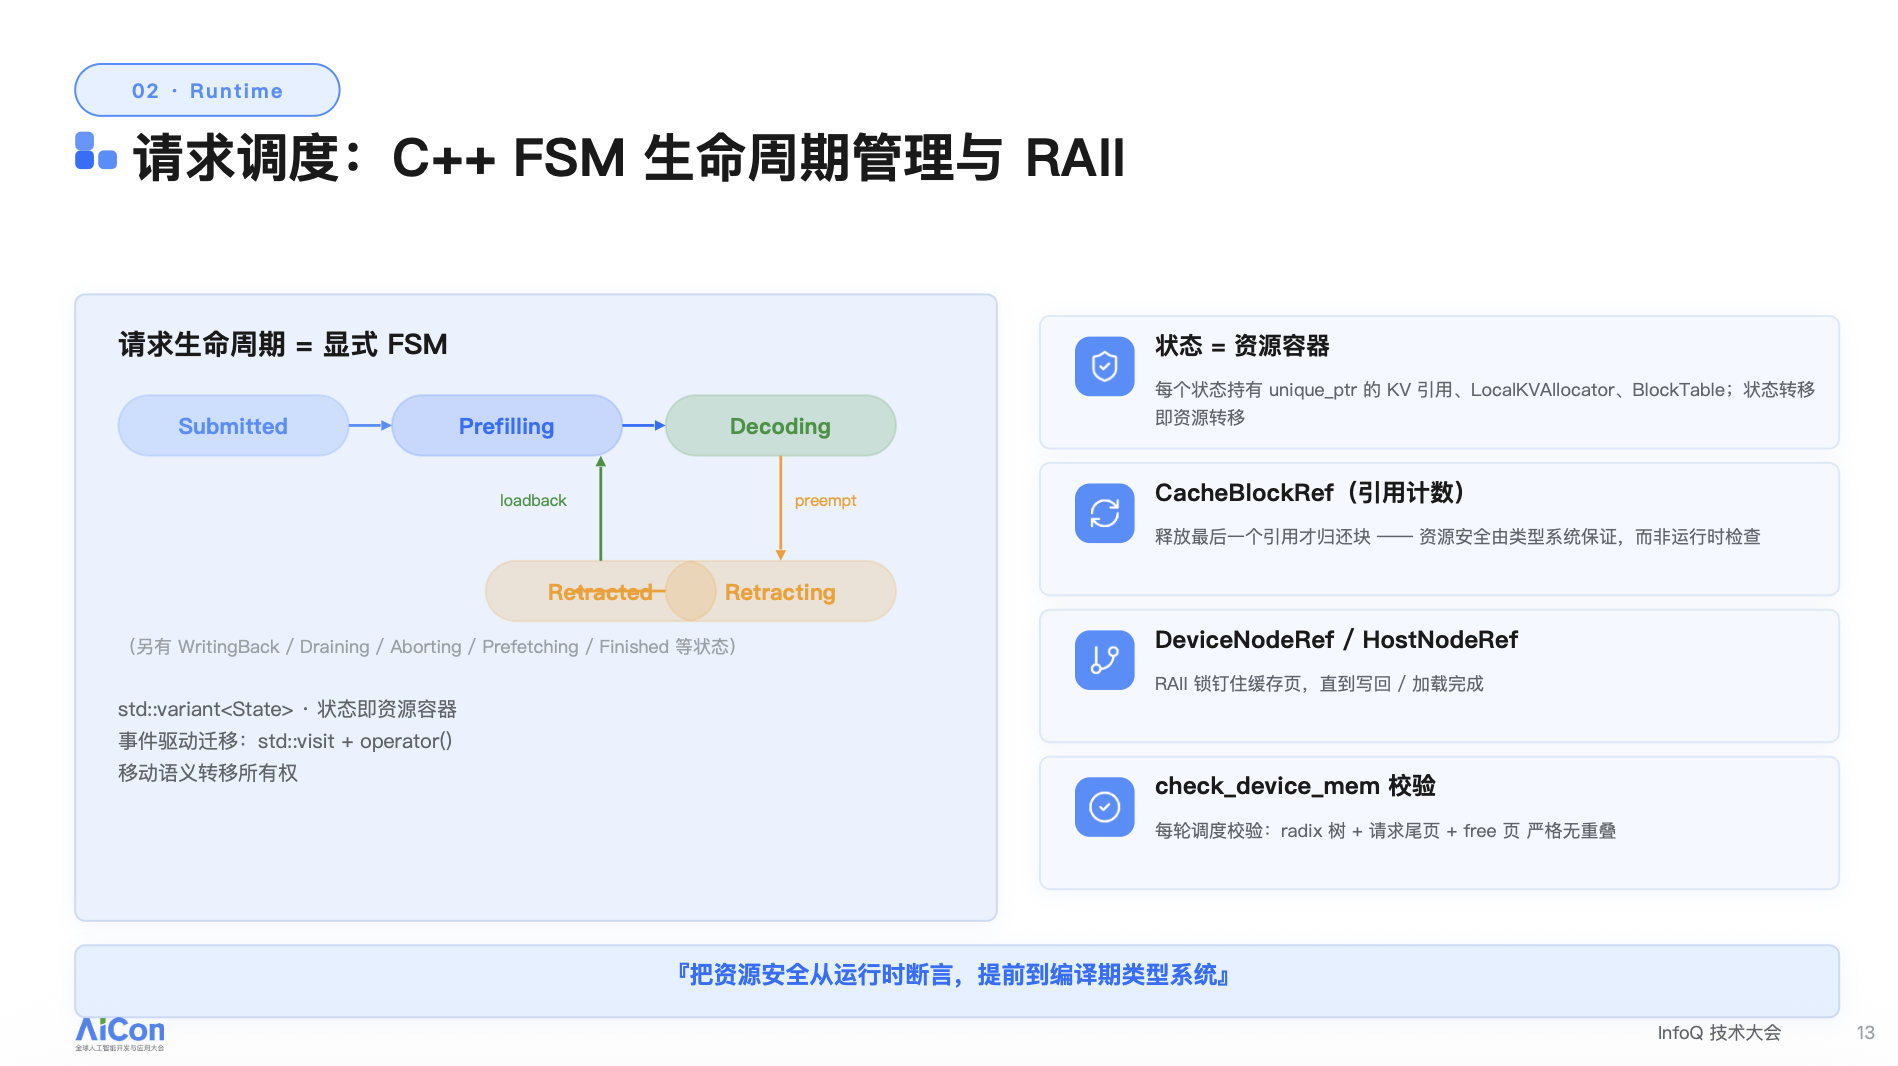
控制面的核心是一个覆盖单个请求全生命周期的状态机。一个推理请求从进入到完成,不可避免地要经历几个关键状态:submitted、prefilling、decoding、retracting/timeout、finished。每个状态本身是一个资源容器,持有该状态所需的 KV 页引用、SSM/MLA 的 slot 列表等资源。当状态发生迁移时,这些资源的持有权同步传递给下一个状态。整个控制面就是一个持续流转的状态机系统。
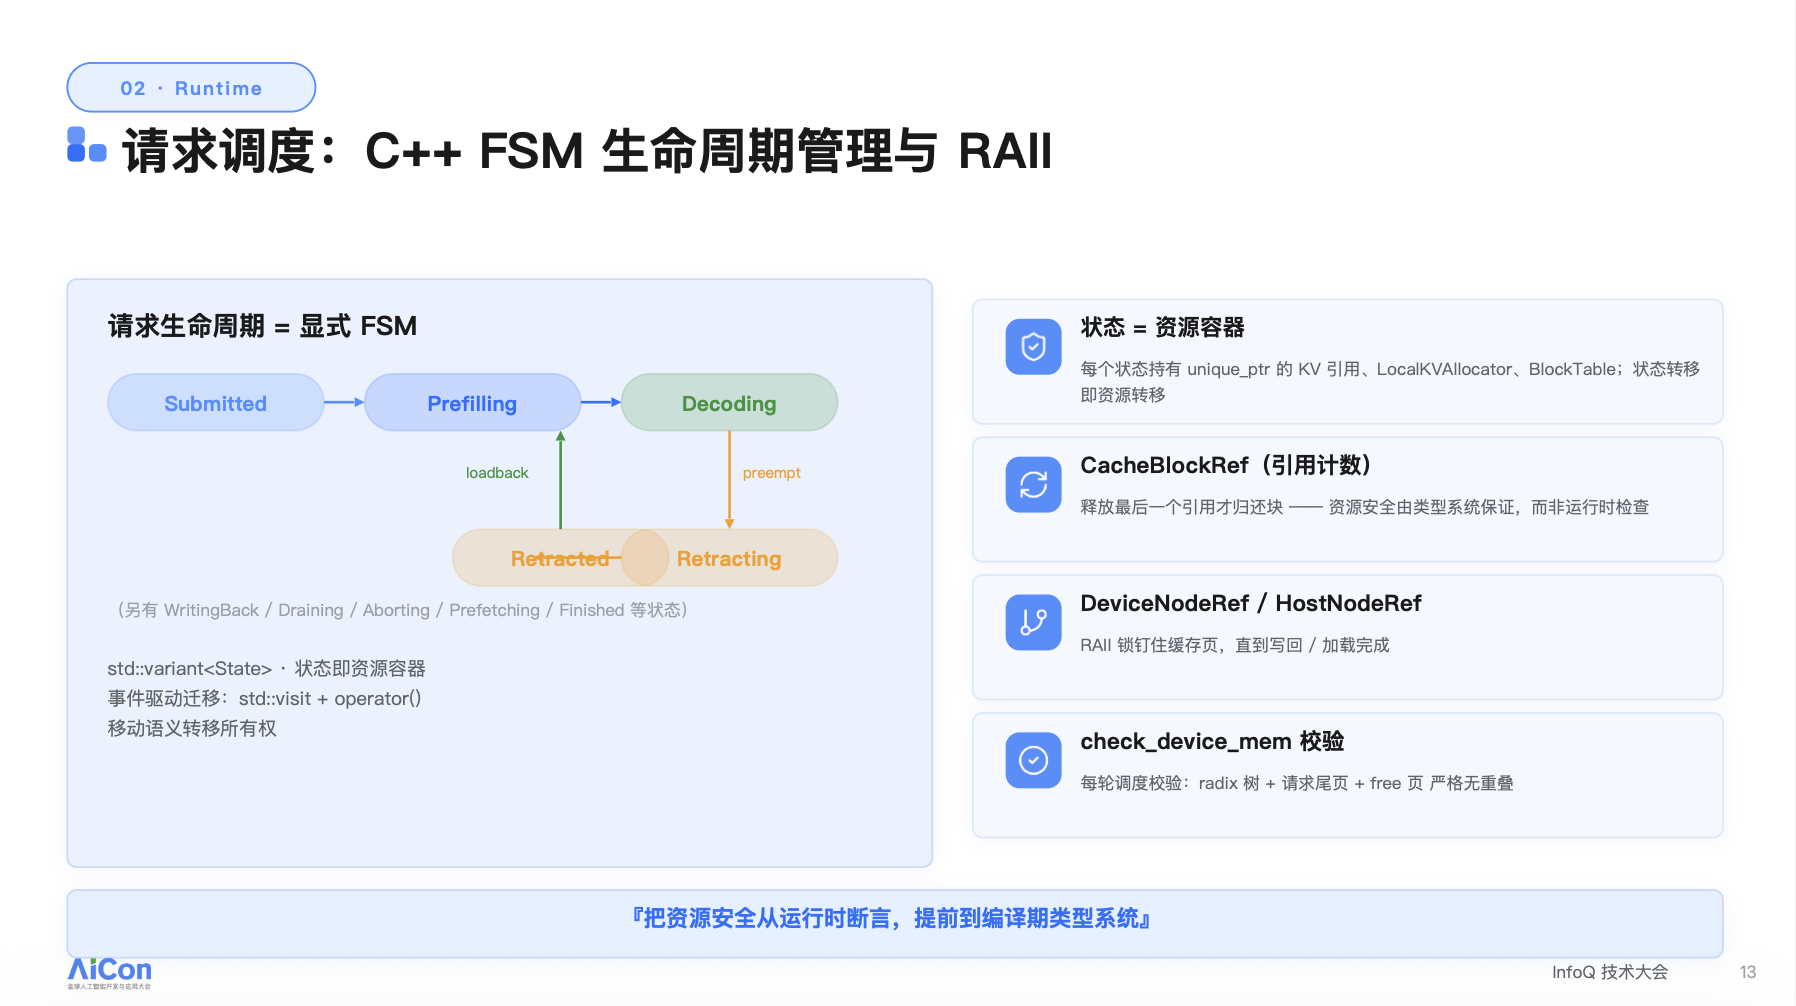
状态迁移通过事件驱动机制完成。每个事件承载着对应的 C++ operator 操作符,在状态转移过程中,资源的所有权通过 C++ 的 unique_ptr move 语义进行传递。这种设计的巧妙之处在于将运行时的资源管理问题提前到了编译期。当代码编译通过时,编译器实际上已经验证了资源泄漏和资源分配错误的问题。因为所有的资源转移路径都在类型系统中被显式地定义和检查。资源本身采用 RAII(Resource Acquisition Is Initialization)方式管理,无论是 Cache Block 的引用计数,还是 Device Node 或 Host Side 的引用计数,在数据搬移或操作完成之前,对应的资源都不会被提前释放。
控制面的状态机设计与执行面完全解耦。调度器只需要关注何时将请求从 prefilling 状态推进到 decoding 状态、何时需要触发 retracting,而不需要关心底层 Kernel 如何执行具体的计算。这种解耦使得调度策略可以独立迭代,不必因为底层算子的调整而频繁修改。Runtime 层接收来自控制面的执行计划,按照计划中定义的顺序和资源配置执行计算,执行完毕后将结果返回给控制面,驱动状态机继续流转。
在实际工程中,这种状态机设计显著降低了并发请求调度中的竞态和资源泄漏问题。过去在 Python 实现中常见的资源管理 bug,比如某个请求被取消后 KV 页未能及时回收、或者引用计数在异常路径下未被正确递减,在 C++ 实现中通过编译期检查和 RAII 机制得到了系统性的解决。这也是我们将控制面完全用 C++ 重写的核心动机之一。
KV Cache 管理是 TokenSpeed 架构设计中投入精力最大的模块之一。Agent 场景下的前缀复用对缓存系统的要求远高于传统 Chat 场景。同一个 Agent 请求在一次完整的工作流程中会反复携带相同的前缀上下文,如果每次循环都需要重新计算 prefill,推理成本会急剧膨胀。
我们在第一版实现中借鉴了 SGLang 的思路,使用 Radix Tree 作为前缀缓存的管理结构。Radix Tree 的设计出发点是维护一棵从根到叶的树形结构,树上的每个节点对应一段 token 序列,所有请求的前缀匹配都在这棵树上进行。这种设计在纯 attention 场景下工作良好,但当我们开始适配 Kimi K3 时发现,Radix Tree 的语义与某些新型注意力模式存在冲突。Mamba 类模型和 Sliding Window Attention 天然地破坏了 Radix Tree 所依赖的层级匹配假设,它们的缓存访问模式不是简单的从前缀到后缀的线性延伸。
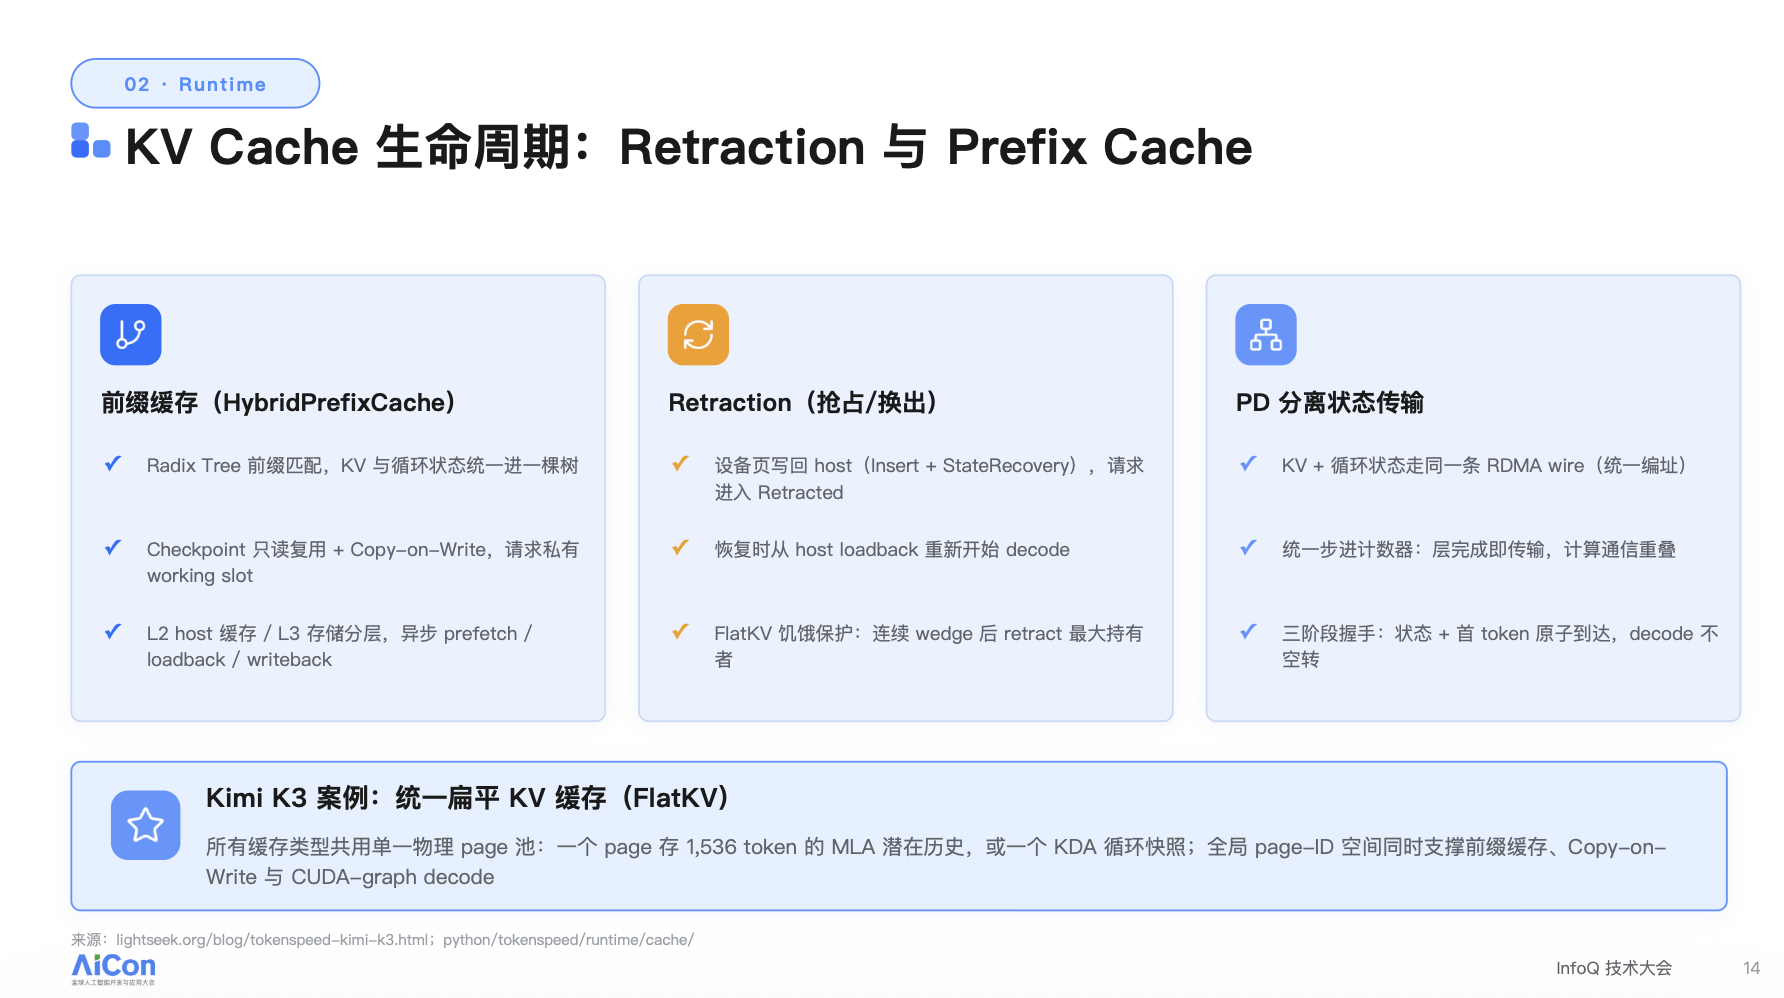
这一经验促使我们重构了 KV Cache 管理系统。在支持 Kimi K3 的过程中,我们将原本的 Radix Tree 全部迁移到 Flat KV 设计。新的缓存系统不再感知缓存的注意力类型,只要求上层将不同类型的缓存按照统一的格式上报给系统,声明各自的类型和占用空间。底层将所有缓存统一打包成相同尺寸的 block,做平面的存储管理。K3 第一版使用逻辑 block 和物理 block 相等的方式,以 1536 个 token 为一个 block 进行管理。但这个粒度在长上下文场景下导致前缀复用效率和页内碎片问题都比较突出。后续我们借鉴了 vLLM 的做法,引入两层 block 设计:第一层是逻辑块,块大小统一为 128;第二层是物理块,块大小为 1536。128 大小的逻辑块用于前缀复用和更细粒度的缓存匹配,物理层则保持不变。这种双层设计在后来的测试中取得了不错的优化效果。
缓存抢占与恢复是另一个关键能力。TokenSpeed 目前完全接入 Mooncake 的 KV Store 系统。当显存不足时,请求的整个 KV 状态被卸载到 KV Store 中做持久化,待请求重新被调度回来时,通过 lazy 化的 reload 机制重新加载并继续计算。PD 分离(Prefill 与 Decode 分离)方面,我们最初实现的是逐层传输的方式。但逐层传输会导致 RDMA 的带宽利用率非常低,因为每一层的传输都需要独立的网络往返开销。后续我们做了优化,允许用户指定将若干层打包成一个 block 进行传输,即一种可定制的分层传输策略。这种灵活性使得用户可以根据具体的网络拓扑和模型规模来调节传输粒度。
Kernel:让 MLA 真正跑满 GPU
Kernel 层的优化工作在 TokenSpeed 中主要由团队中的 NVIDIA 和 AMD 专家推动。目前 TokenSpeed 的 Kernel 在 Blackwell 上已经达到 state-of-the-art 的性能水平,并且被 vLLM 社区集成为 Blackwell 上的默认 Kernel 包。
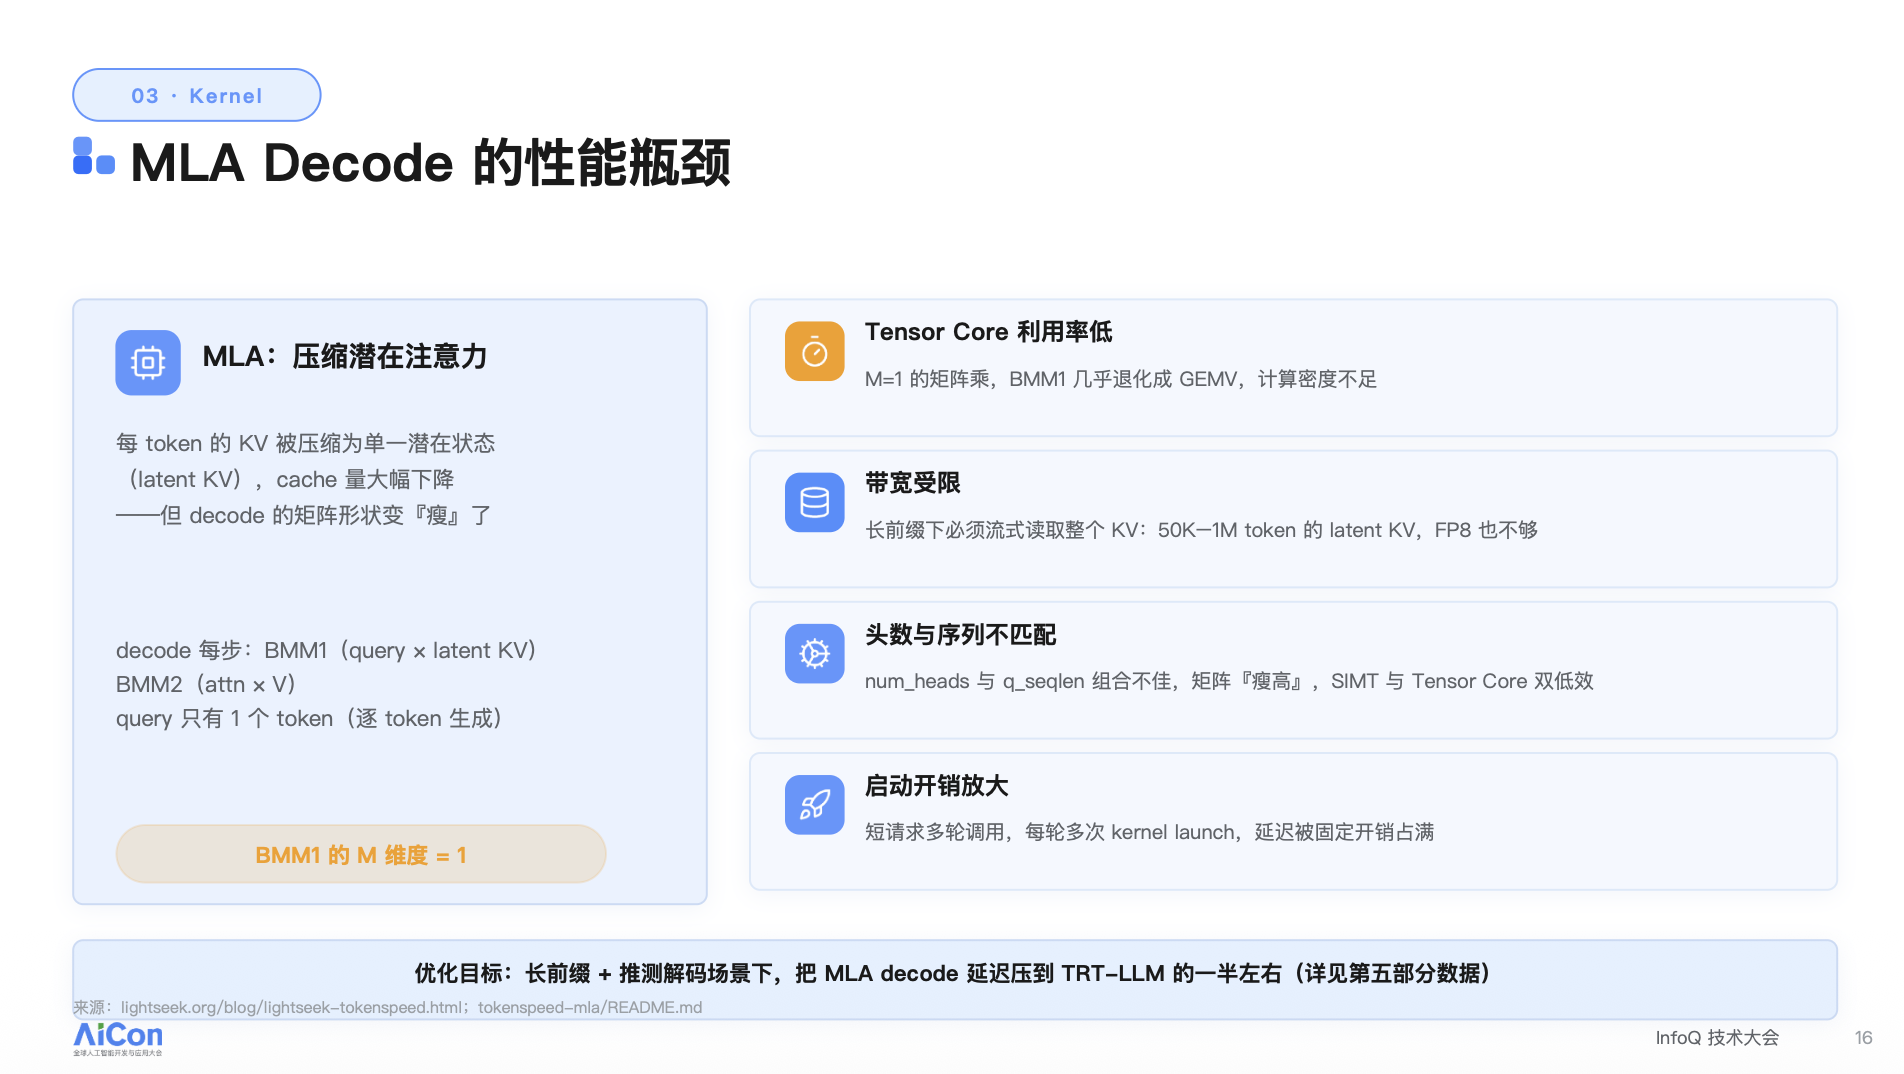
MLA(Multi-head Latent Attention)是当前国内开源模型广泛采用的注意力机制。MLA 虽然通过将 KV 压缩为单一的 latent 状态来节省写成本,但它的计算模式对硬件并不天然友好。在 decode 阶段,query 与 latent key 的第一次矩阵乘法中,query 的维度是 1,整个矩阵乘法实际上退化成了向量乘法。这意味着 Tensor Core 的计算资源在 Blackwell 上被严重浪费。第二个瓶颈在于带宽。Agent 场景下前缀长度常常达到几十 K 甚至几百 K,即便使用了 INT8 量化,带宽数据加载仍然是限制因素。第三个问题是形状不匹配:MLA 的 head 数和训练长度组合往往导致矩阵乘法呈现瘦高形态,对 SM 的利用率和 launch 开销都产生负面影响。
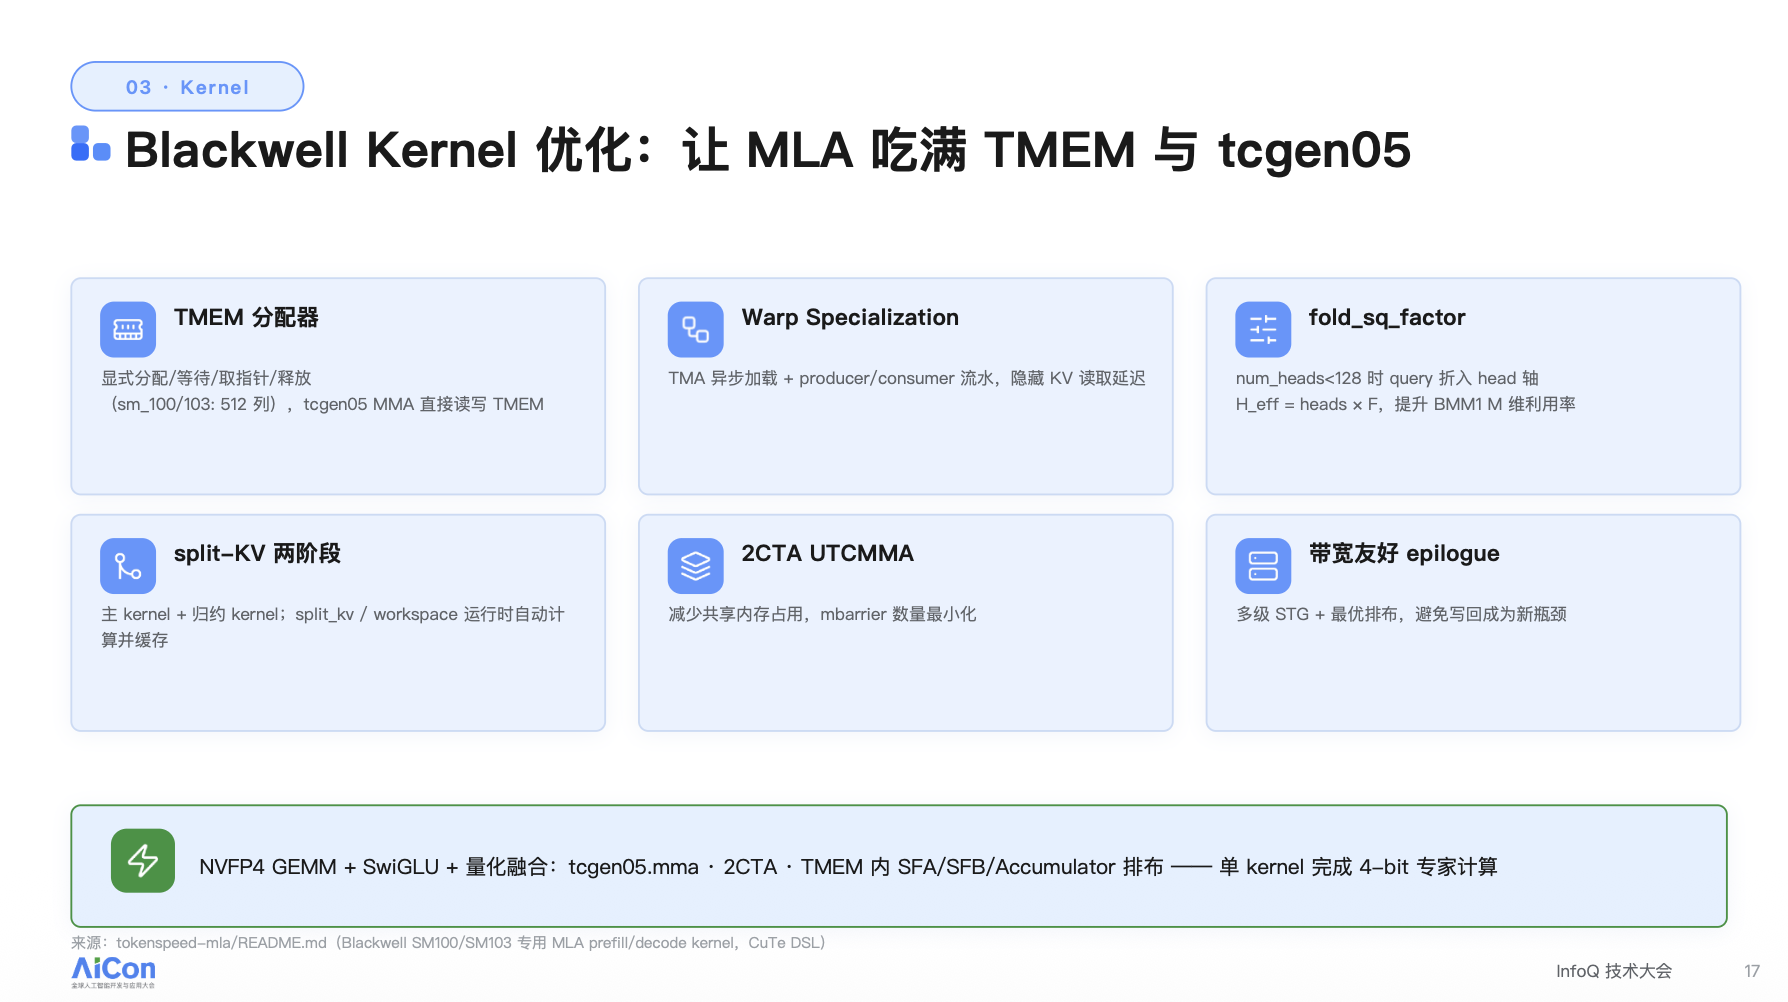
针对这些问题,我们在 Blackwell 上重新设计了 Kernel。首先,充分利用 Tensor Memory 这一新引入的片上内存资源。我们专门编写了 Tensor Memory 的分配器,让 Tensor Core 直接读写 Tensor Memory,避免了通过寄存器进行中间数据搬移的开销。其次,在矩阵乘法层面引入了一个折叠因子(fold factor)的优化技术。由于 decode 阶段 query 维度为 1,Tensor Core 利用率极低。我们发现当 head 数小于 128 时,可以将 query token 折叠到 head 维度中。经过折叠后,有效的 head 维度乘以折叠因子,矩阵维度变高,Tensor Core 便可以进行更高效的计算。此外,我们还设计了 Split KV 机制,将计算拆分为两个阶段:第一阶段计算 Split KV 的部分和,第二阶段做归约操作。Split 参数和 workspace 的大小在运行时自动计算并缓存。跨 SM 的协同执行减少了 MMA barrier 的开销,数据写回时也做了带宽友好的优化。这些优化组合在一起,使得 TokenSpeed 的 Kernel 在 Blackwell 上达到了 leading 水平的性能。
投机解码是当前提升推理吞吐的重要特性。EAGLE、DeepSeek 等算法的出现都带来了显著的吞吐提升。TokenSpeed 的仓库目前已经支持三种投机解码算法:MTP、EAGLE3 和 DeepSeek。同时我们也在使用 TokenSpeed 去支持 DeepSeek 发布的推理引擎中提出的投机解码算法,后续会为开源模型专门训练一批对应的投机模型权重,放入 TokenSpeed 仓库中供社区使用。在Inkling 975B 这个开源模型上,我们在四张 B200 上做了测试:MTP 步数为 3 时每步 TPS 为 317,步数为 8 时为 355,相对于关闭 MTP 的基线,整体性能提升了 2.08 到 2.33 倍。在千问 3.5 上,MTP 带来的性能收益在 100% 到 159% 之间。
对于线性注意力模型,TokenSpeed 也做了针对性优化。线性模型中 MLA 状态随 token 的生成不断向前更新,当达到某个截止时间点时需要将状态写回,这个写回操作会带来一定的开销。我们的做法不是搬移数据本身,而是操作指针,将数据搬移的开销降到最低。每一步的状态直接写入该请求的私有物理行中,用一个索引标记状态所在的位置。当需要截止时,只更新索引指向,而不是搬移整个状态块。在 prefill 场景中,Agent 负载的前缀命中率通常在 90% 以上,此时只需要追加几百个 token 的计算。这意味着 request 的 shape 是变长的,Q 和 KV 的长度也不相等。TokenSpeed 的 MLA Kernel 支持无 padding 的变长批处理,默认实现使用 QDLS 实现,性能表现良好,同时也提供了预编译的 binary 通过 TMA 接入。
跨平台 Kernel 设计
随着推理硬件的多样化,跨平台能力成为推理引擎必须面对的问题。NVIDIA、AMD、华为、平头哥等厂商的加速器各有不同的硬件架构和编程模型。如果 Kernel 代码直接绑定在特定的硬件接口上,每支持一种新硬件都需要大规模重构。TokenSpeed 在设计 Kernel 层时参考了 Linux 内核的抽象思路,建立了 register 和 selector 的机制。
模型适配代码完全不感知底层运行的具体硬件接口。它只调用公共的 AI API 或者公共的 prefix API。这些 API 在设计时经过仔细定义,确保后续不轻易变动。API 的描述类型涵盖张量格式、执行约束等必要参数。底层厂商在实现各自的 Kernel 时,通过 register 机制将自己的内核注册到系统中,声明所支持的操作类型、capability、signature、优先级以及特定的 Tensor Core 特性。运行时系统通过 select kernel 动态地根据平台能力和格式进行过滤,选择最合适且最稳定的 Kernel 完成模型的前向计算过程。
这种设计为不同阶段的开发者提供了分层的接入路径。新模型接入时,可以先用 reference 代码(例如用 PyTorch 编写的实现)把整个模型跑通,建立正确性基线。然后再将 reference 代码替换为 specialized 的定制 Kernel,逐步提升性能。优先级分层机制允许同时存在 reference 实现、performance 实现和 specialized plugin 实现,系统根据注册时的优先级自动选择。TokenSpeed 的 Kernel 包有独立的 AMD Build,AMD 团队基于这套系统完成了对 AMD GPU 的独立适配。
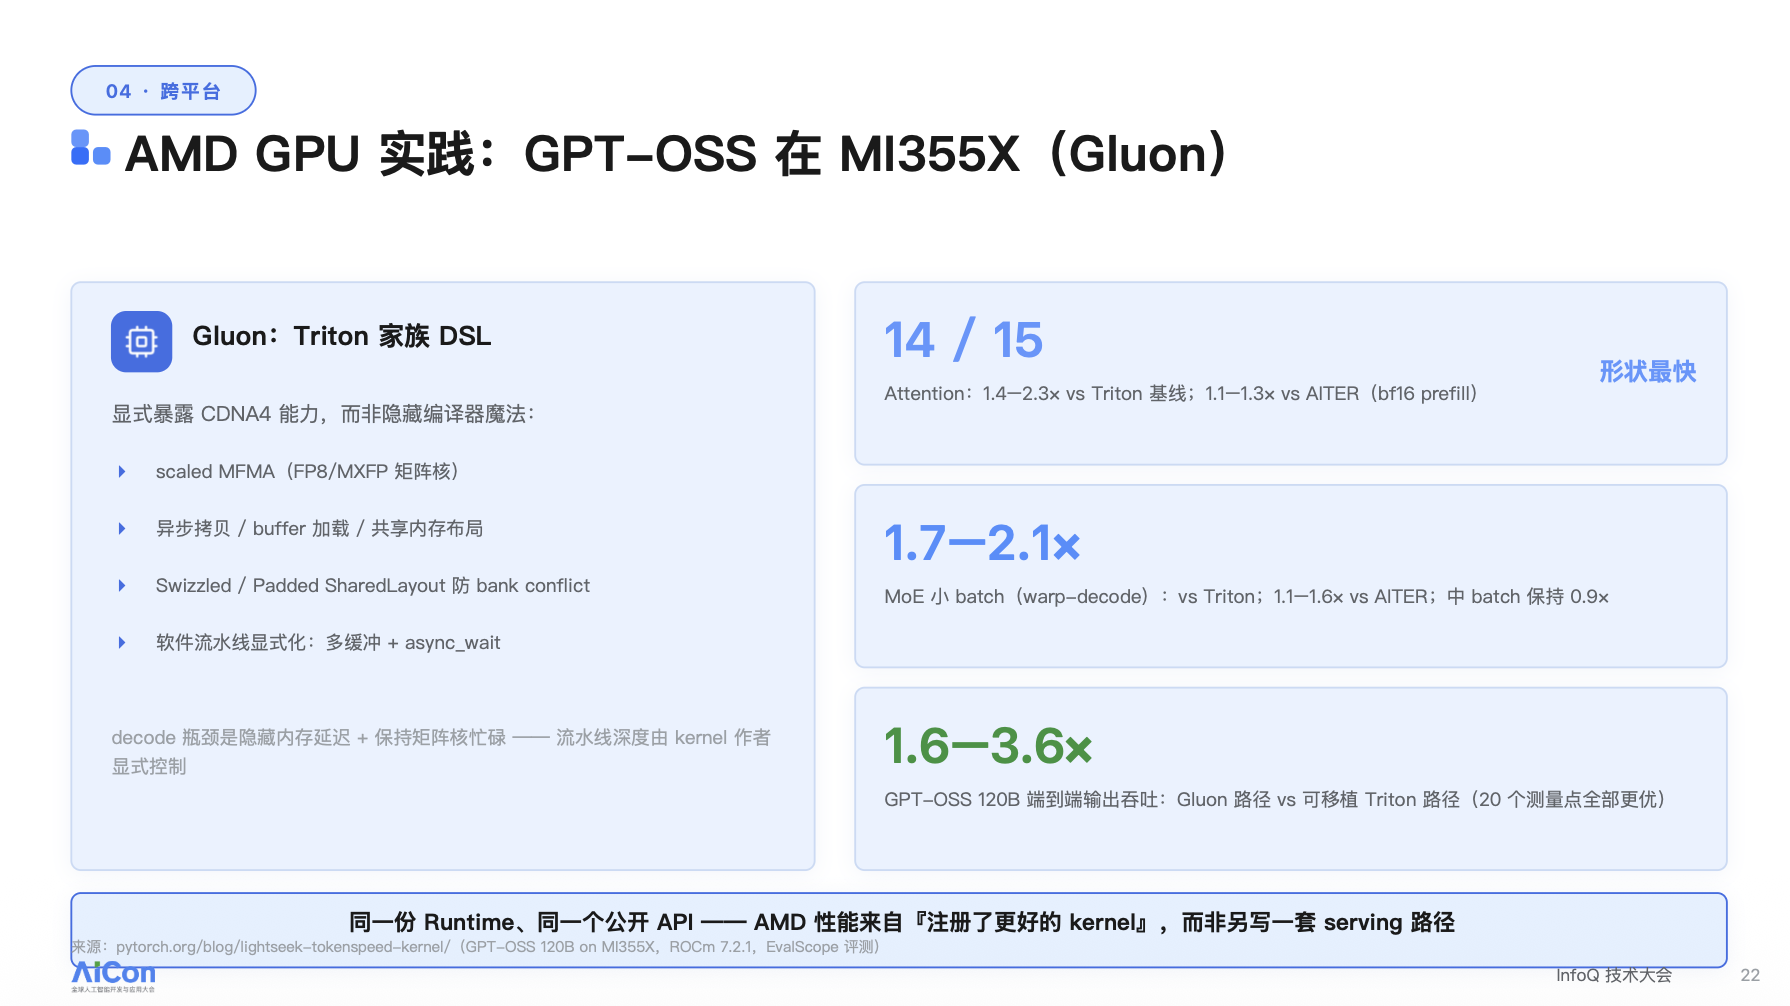
在 AMD 的 MI355X 机器上,使用其 CDNA4 架构的 DSL 能力,开发者可以精细管控流水线和内存布局。在注意力层面,采用 persistent prefill Kernel 实现跨 CDA 的均衡调度。测试结果显示,在 15 种典型的 prefill 形状中有 14 种快于 TensorRT,领先幅度为 1.4 到 2.3 倍;在 MOE 的小 batch rop decode 场景中,比 TensorRT 快 1.7 到 2.1 倍。端到端测试在所有测量点上均实现性能优势。
工程实践与性能收益
经过几个月的迭代,TokenSpeed 在 Blackwell 平台上取得了一系列可量化的性能成果。在发布版本中,我们以 TensorRT-LLM 作为对比基准。TensorRT-LLM 作为 NVIDIA 官方的推理引擎,在 Blackwell 上本身已经具备相当高的优化水平。测试环境基于单机 Blackwell、非 PD 分离架构、使用 EvalScope 这个一键 benchmark 进行流量测评。结果表明,在延迟约束下的吞吐优化这个核心维度上,TokenSpeed 在所有测试场景中都不弱于 TensorRT-LLM。在 batch size 等于 1 的最小延迟场景下快 9%,在每用户 100 TPS 的工作点上每 GPU 吞吐提升 11%。在千问 3.5 397B 模型上,B200 八卡、batch size 等于 1 的配置下跑到了 580 TPS,这在当时是一个比较突出的水平。
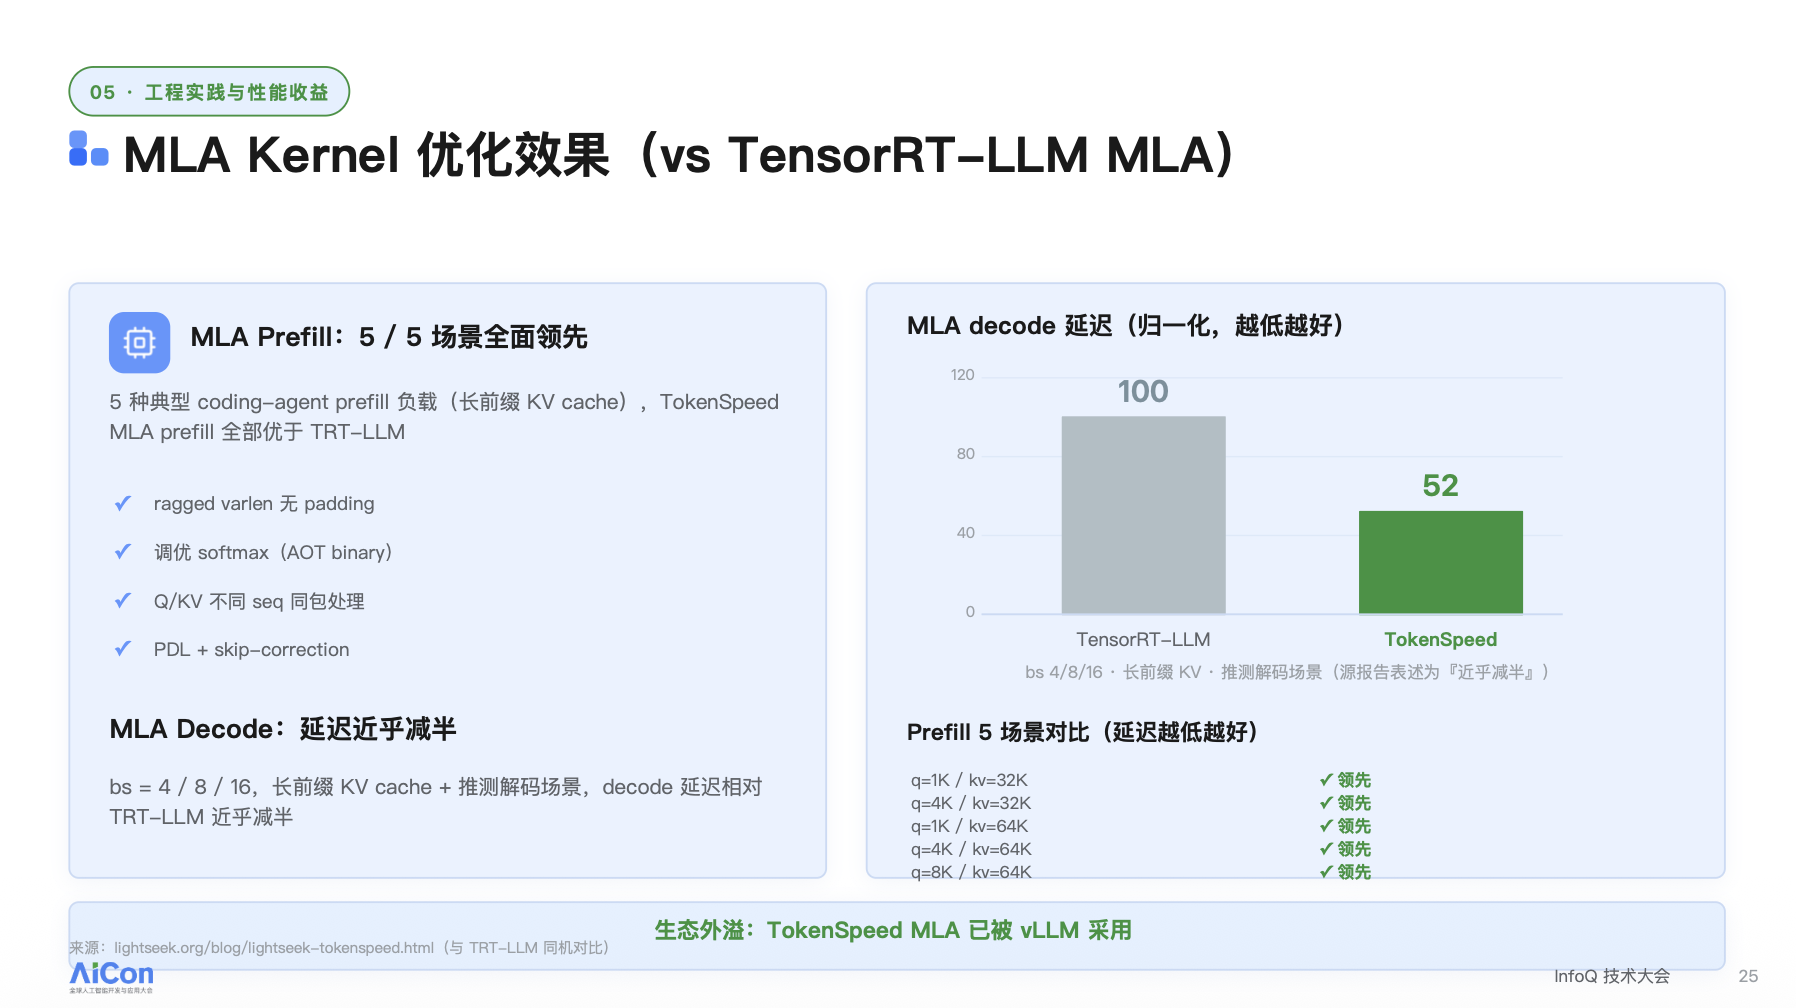
MLA Kernel 的优化效果同样显著。在五种典型的 coding agent prefill 负载上,TokenSpeed 全部优于 TensorRT-LLM。在投机解码的 batch size 等于 1 场景下,延迟相对于 TensorRT-LLM 几乎减半。跨模型支持方面,千问 3.5 从 128K 上下文扩展到 1M 时,解码吞吐仅下降 16%,展示了较强的扩展性。在 Kimi 2.5 上,每用户 TPS 达到 423。Kimi K3 当时处于 Day-0 支持状态,优化工作仍在持续迭代中。
回顾整个项目,可以提炼出几条核心的设计原则。第一,在 Agent 场景下,推理引擎的优化目标必须从单纯追求吞吐转向延迟约束下的吞吐最大化,以 Pareto 前沿作为评价推理引擎性能的核心框架。第二,系统分层必须清晰,控制面只负责调度决策,不触碰数据面;Runtime 只负责执行;Kernel 只负责计算。第三,并行切分逻辑必须从模型适配链路中抽离出来,通过 Placement 系统和自动并行编译实现声明式的模型部署。第四,Kernel 优化必须充分发掘新硬件特性,同时通过抽象层为多硬件生态提供友好的接入路径。TokenSpeed 作为一个开源数月的年轻项目,仍在快速迭代之中,我们期待社区的反馈和贡献。
热度延续:12 月 AICon 北京站见
12 月 18–19 日,AICon 全球人工智能开发与应用大会将在北京举办。本届大会以探索 A 应用边界为主题,设置 13 大技术专题,覆盖大模型后训练、推理优化、Agent 工程、知识工程、智能体评测与安全、自进化系统、AI 软件交付、原生架构及组织变革等核心方向,汇聚一线技术专家,深入分享 AI 技术突破与企业规模化落地的真实实践。