一次 Agent 任务平均消耗 417 万 Token、调用费近两美元,速度和价格成了产品上线前提。腾讯 Hy4 Flash 定位更快更便宜的日常 Agent 模型,用混合注意力与 Engram 架构把激活参数压到 12B。实测从速度、成本与准确率三方面看它的取舍。
Agent 真正普及后,模型竞争的指标变了。以前大家关心新模型超过了谁、能不能完成过去做不到的任务;现在更现实的问题是:一次工作需要调用几十轮模型,团队到底能不能等得起、付得起。
一项覆盖 8 款模型和 500 个真实代码问题的研究显示,Agent 每次尝试平均累计消耗约 417 万 Token,模型调用费约 1.86 美元。连续跑十次,成本就接近 20 美元。对于每天处理大量代码、文档和办公任务的团队,速度和价格不再是附加指标,而是产品能否上线的基础条件。
腾讯 Hy4 Flash 的定位正是“更快、更便宜的日常 Agent 模型”。它不是要在所有复杂推理榜单上取代旗舰模型,而是希望用较低成本承担办公决策、视觉理解、编程修复和 PPT 生成等高频任务。
Hy4 Flash 的架构,目标是把每次调用做轻
Hy4 Flash 总参数量为 224B,其中包含 64B Engram 参数;通过混合注意力、LatentMoE 和 Engram 等架构设计,实际激活参数约 12B,KV Cache 规模约为 Hy3 的 1/24、Hy4 的 1/6,并支持多模态和 1M 上下文。
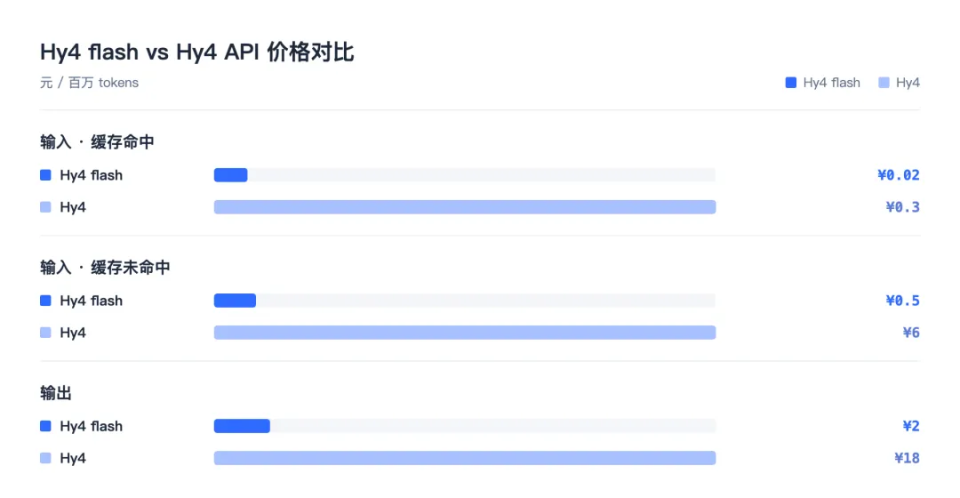
后训练阶段,模型通过自蒸馏 Hy4 获得综合能力,再通过强化学习降低端到端任务输出长度。官方给出的目标是:整体单任务成本约为 Hy4 的二十分之一,解码速度超过 150 tokens/s。
价格也明显偏向高频调用:每百万输入 Token 0.5 元、输出 Token 2 元,缓存命中时为 0.02 元。开发者需要注意,这些价格优势只有在任务调用次数、上下文缓存和输出长度都控制得住时,才能转化为真实账单优势。
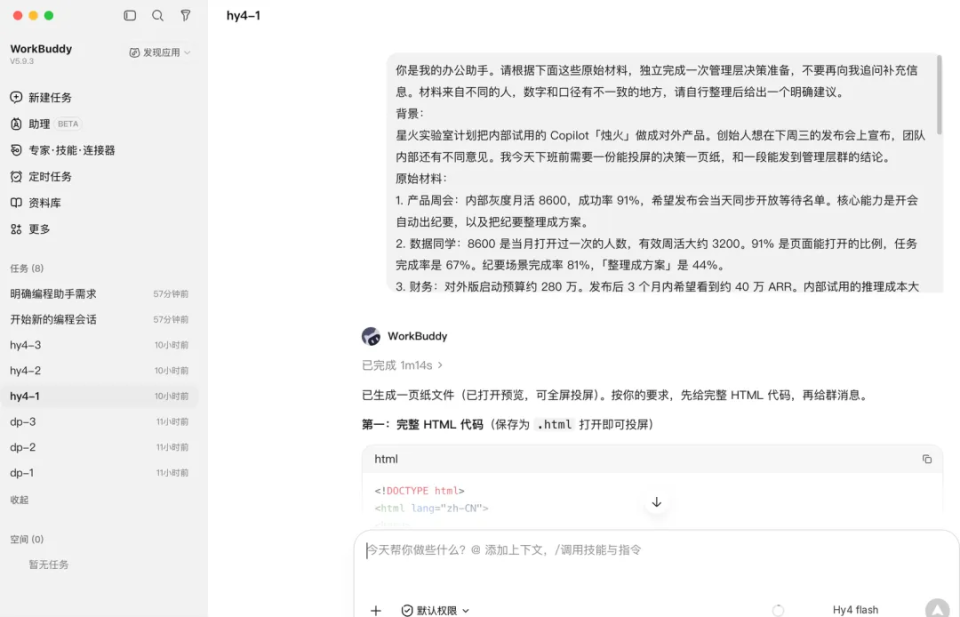
第一轮:复杂办公决策,快不等于判断更差
测试设置了一组互相矛盾的产品数据:产品部门说有 8600 人打开过产品、成功率 91%;数据部门给出的每周真实使用人数约 3200,任务完成率 67%;销售有 6 家感兴趣,其中 1 家愿意付费试点;财务希望发布后三个月达到约 40 万 ARR;法务则表示安全评估无法在发布会前完成。
模型需要判断应该相信哪组数字,并交付一页可以投屏的发布决策纸。
Hy4 Flash 用时 1 分 14 秒,建议发布会照开,但只宣布即将开放、分批放量,现场不开注册;对外采用更严格的 3200 人和 67% 数据,并把等待名单是否属于“开通注册”列为待确认事项。
DeepSeek-V4.1-Flash 用时 4 分 8 秒,核心判断基本一致,只是建议发布会收集等待名单。这个差异不构成明显错误,因为法务限制的是现场开通注册,并没有明确禁止收集名单。
这一轮最明显的差距在速度:Hy4 Flash 少用了 2 分 54 秒,完成时间约为对手的三成,而核心判断和交付质量没有明显差距。
第二轮:读图决策,准确率和速度开始分叉
第二轮把上一轮文字材料加工成一张带有矛盾的投屏图片。大卡片写着月活 8600、成功率 91%、意向客户 6 家,并标注“可计收入”;右下角对照表却显示更严格的数据。图表还把 8 万和 40 万标成柱状图,但 8 万那根柱子的高度明显画到了约 32 万。
Hy4 Flash 用时 2 分 46 秒,继续建议采用更严格的数据,并识别出 6 家意向客户与 1 家付费试点之间的冲突,也把 8 万元到底是确认收入还是预算、40 万元的时间口径列为待确认事项。不过,它没有发现 8 万元柱高画错的问题。
DeepSeek-V4.1-Flash 用时 1 分 25 秒,比 Hy4 Flash 更快,但把“可计收入”读成“非付费”,并错误地认为 8 与 40 的数值比例等于图形比例,因此判断图表没有失真。
这轮结果很有代表性:更快的模型不一定更准确,更强的模型也可能漏掉视觉细节。生产系统不能只看平均响应时间,应该把关键数字、图表比例和决策条件做成可自动检查的校验项。
第三轮:真实库存项目,Flash 模型已经够用
第三轮让 Hy4 和 Hy4 Flash 接手一个正在使用的库存与计价系统。仓库原有测试全部通过,但线上出现四个问题:预占库存误扣在库数量、整单出库报错、优惠券没有按 50 元上限封顶、月末报表漏掉 11 月 30 日。
任务要求模型自己读代码、重现问题、补测试、修复实现,并提交修复说明。
Hy4 Flash 用时 2 分 5 秒,找到了四个问题并完成修复:预占后不再误扣在库数量,取消操作可以释放预占,整单出库恢复正常,优惠券按上限封顶,报表区间包含结束日期。它还新增 5 个测试,验证预占、取消、优惠券和月末报表行为。
正式版 Hy4 用时 3 分 49 秒,根因和改法基本一致,但新增了 8 个测试,流程更完整。这个结果说明,Flash 模型在明确、可回归、风险可控的代码修复任务上,已经具备很强的性价比;旗舰模型的优势更多体现在覆盖范围和验证深度,而不一定是每个任务都更快。
第四轮:论文转 PPT,质量和速度要分开评价
最后一轮让两个模型把 OpticalRAG 论文制作成可讲解的 PPT,要求覆盖问题、核心方法、实验结果、局限和落地注意事项,并准确呈现论文中的关键数字。
Hy4 Flash 用时 9 分 5 秒,生成 21 页 PPT,论文的两项关键技术、实验数据和局限都被覆盖,主结果表也更完整。缺点是部分页脚与正文重叠,公式指数没有正确做成上标。
Hy4 用时 15 分 47 秒,生成 18 页 PPT,同样保留了关键数字,并更适合直接讲解,对结论的分析也更完整。
这轮不能简单说谁赢了。Hy4 Flash 更快、内容更全,适合快速形成第一版;Hy4 更慢,但页面质量和讲解体验更好。最合理的工作流可能是让 Flash 模型先生成可编辑初稿,再让更强模型或人工做结构、版式和结论审查。
Flash 模型应该放在哪一层
Hy4 Flash 适合深度搜索、文档处理、PPT 生成、简单前端展示、computer use 和常规代码修复等任务。对于长程软件工程、复杂架构设计和高风险决策,仍然需要更高能力模型、更多验证和人工接管。
可以把路由策略设计成三档:
| 任务类型 | 默认模型策略 | 必须补的保障 |
|---|---|---|
| 高频低风险 | Flash 模型 | 预算上限、缓存和简单回归 |
| 中等复杂度 | Flash 初稿 + 强模型复核 | 交叉检查、版本和人工验收 |
| 高风险长任务 | 强模型或多 Agent | 权限隔离、分阶段交付、回滚 |
选择模型时不要只比较单价。真实成本还包括失败重试、人工修改、上下文缓存、工具调用和等待时间。一个每次便宜但经常返工的模型,未必比单次价格更高但一次完成的模型更经济。
国内开发者如果需要通过 API 接入 Hy4 Flash、DeepSeek 等模型,可以了解 [Code80]https://code.ai80.vip/home 这类渠道;但模型路由、上下文预算、工具权限和质量验收仍需要自己维护。
常见问题
Hy4 Flash 能替代旗舰模型吗?
不能。它更适合高频、低成本和中等复杂度任务;长程软件工程、复杂推理和高风险决策仍需要更强模型和更完整的验证链。
为什么 Agent 更需要 Flash 模型?
Agent 一次任务可能触发几十轮模型调用,Token 和等待时间会快速累积。Flash 模型可以降低单任务成本和反馈延迟,适合承担大量中间步骤。
Hy4 Flash 的视觉能力可靠吗?
实测显示它能识别文字、图表和图形矛盾,但也可能漏掉柱状图比例错误。涉及金额和决策的视觉任务仍应加入结构化数字校验。
代码修复为什么要让模型补测试?
只改代码不补测试,无法证明修复覆盖了线上问题。测试可以把模型发现的根因转成可重复验证的行为约束。
PPT 生成应该选快模型还是强模型?
快速生成初稿可以选 Flash;对外汇报、复杂论文和高要求排版则应增加强模型或人工复核,重点检查结构、数字、公式和版式。
国内团队如何接入 Hy4 Flash?
可以通过 Code80 等 API 渠道降低接入摩擦,但仍应自行配置密钥、预算、缓存、工具权限和回归测试。
本文由人人都是产品经理作者【易安说AI】,微信公众号:【易安说AI】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载。
题图来自 Unsplash,基于 CC0 协议